Hadoop和Hive的关系:一分钟彻底搞懂
Hadoop和Hive的关系:一分钟彻底搞懂
一句话总结
Hive是建立在Hadoop之上的一个“翻译官”,它让你能用SQL操作Hadoop上的数据,而不用写复杂的MapReduce/Java程序。
一、形象比喻:餐厅厨房系统
|
组件 |
比喻 |
作用 |
|---|---|---|
|
Hadoop |
整个餐厅厨房 |
提供场地、工具、人员 |
|
HDFS |
厨房的大冰箱+储物柜 |
存储所有食材(数据) |
|
MapReduce |
厨师的做菜流程 |
洗菜→切菜→炒菜→装盘 |
|
Hive |
餐厅的点菜系统+翻译员 |
把顾客的点菜需求翻译成厨师能懂的流程 |
顾客说:“来一份鱼香肉丝套餐” ← 这是SQL查询
Hive说:“好的,翻译成:
-
从冰箱拿肉丝、胡萝卜、木耳 ← 从HDFS读取数据
-
切肉丝、切胡萝卜 ← Map阶段
-
炒菜、调味 ← Reduce阶段
-
装盘上菜 ← 返回结果”
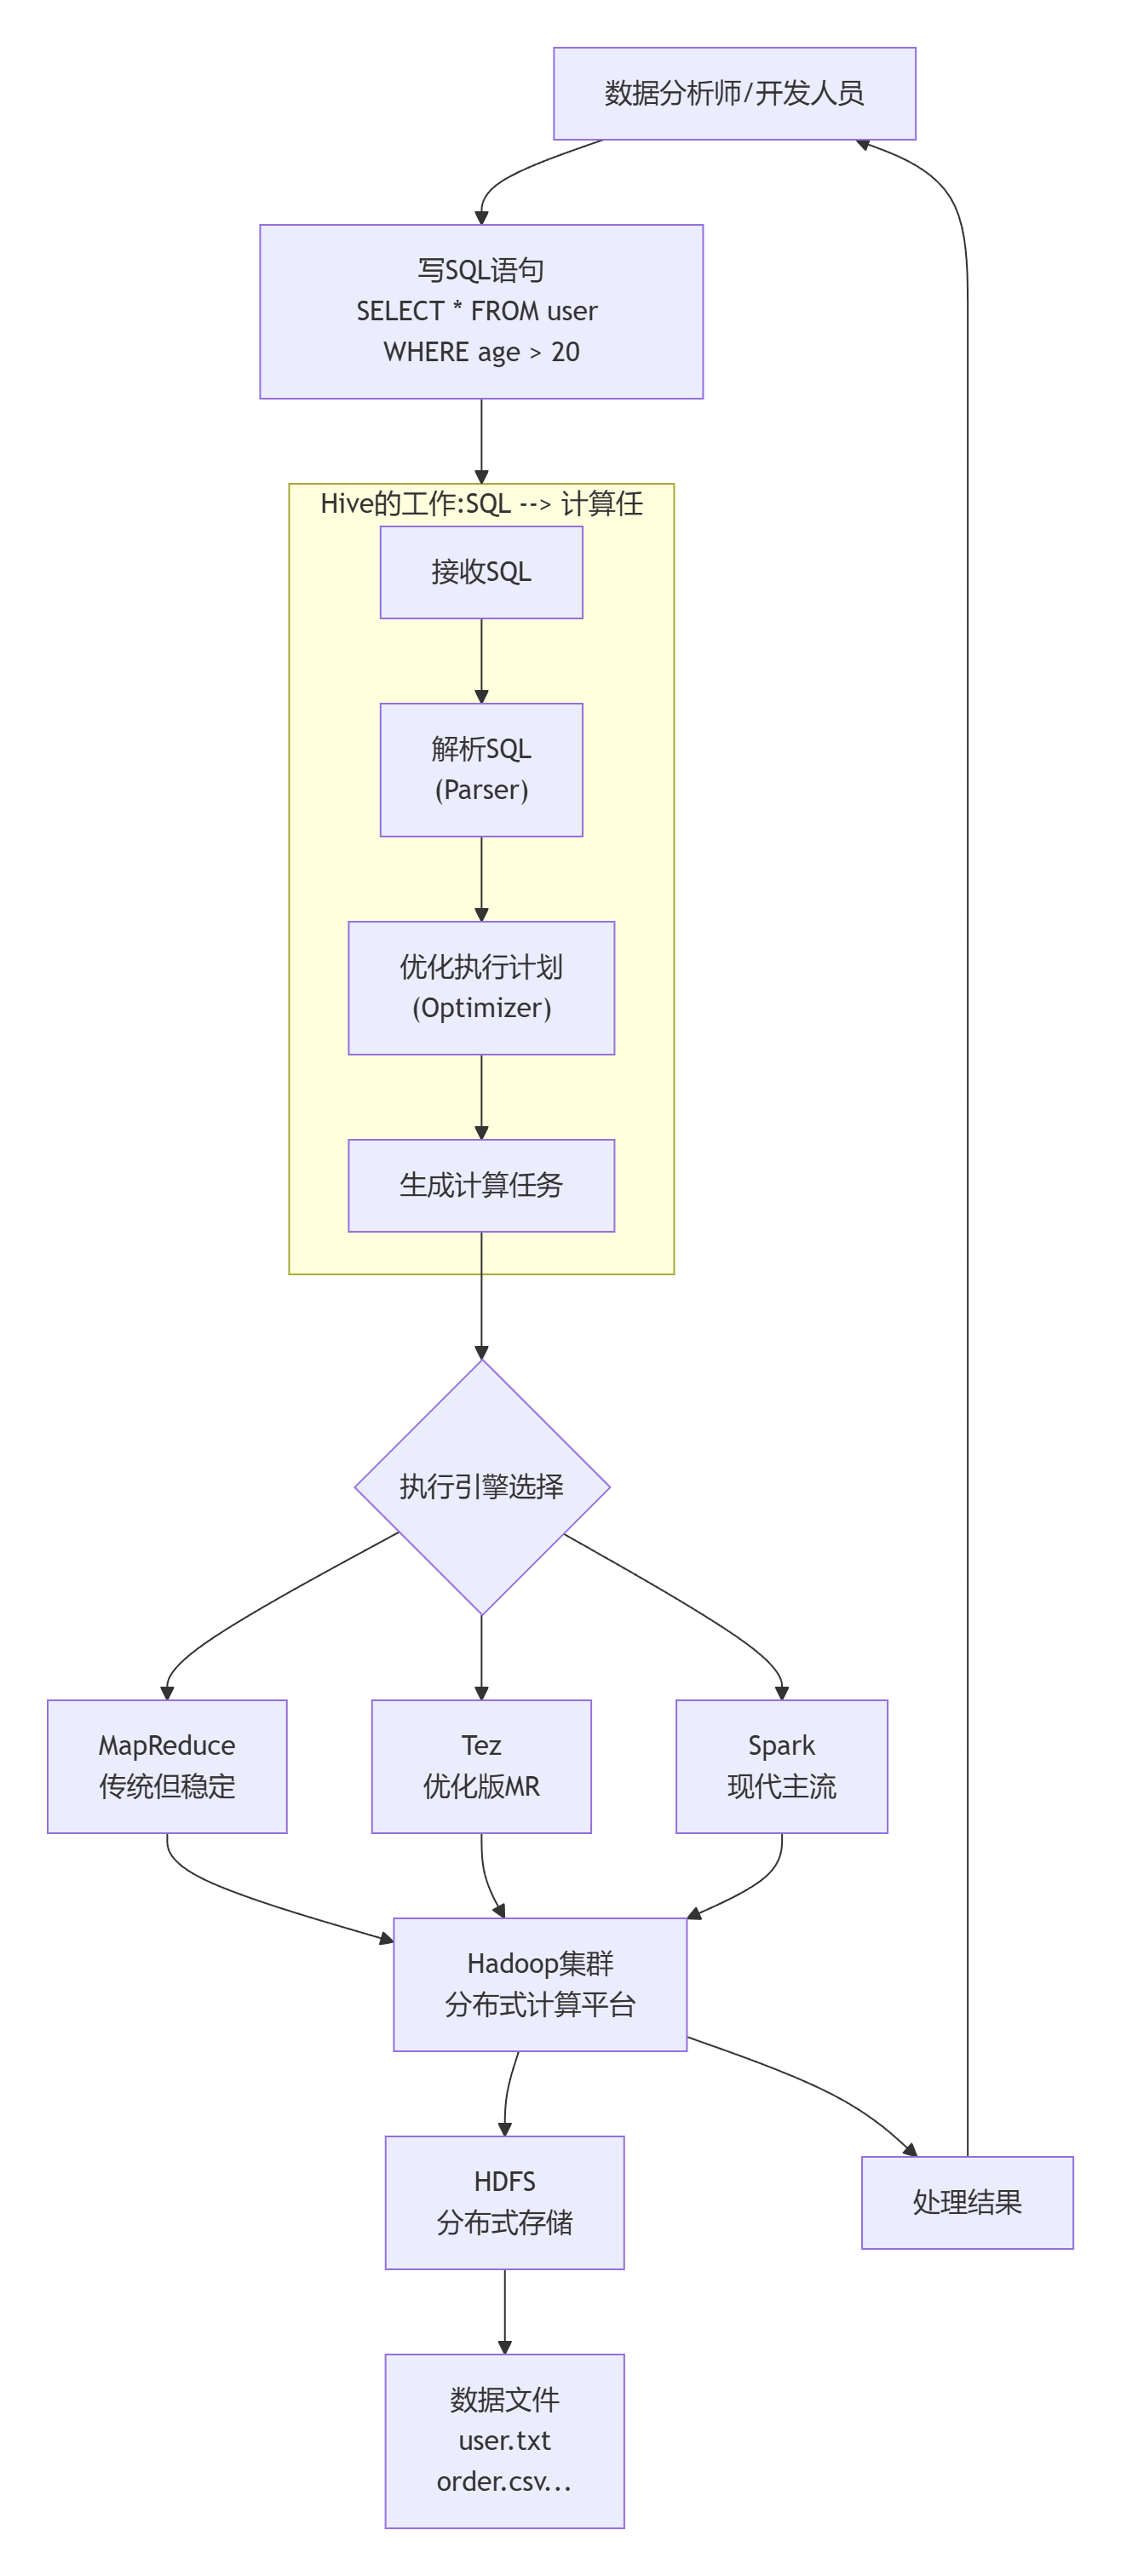
二、技术架构关系图
用户界面层
            ↓
    ┌───────────────┐
    │      Hive     │ ← 你用SQL和它对话
    │  (HiveQL接口) │
    └───────────────┘
            ↓
    ┌───────────────┐
    │  Hive驱动层   │ ← 负责翻译你的SQL
    │ 1. 解析器     │
    │ 2. 优化器     │
    │ 3. 执行器     │
    └───────────────┘
            ↓
    ┌───────────────┐
    │ 执行引擎层    │ ← 选择计算框架
    │ • MapReduce  │
    │ • Tez        │
    │ • Spark      │
    └───────────────┘
            ↓
    ┌───────────────┐
    │    Hadoop     │ ← 底层执行平台
    │ 1. YARN       │ (资源管理)
    │ 2. HDFS       │ (数据存储)
    └───────────────┘
三、核心关系详解
1. 存储依赖关系
-- 你的数据存在HDFS上
/user/hive/warehouse/video_plays/dt=2024-01-01/part-0001
/user/hive/warehouse/video_plays/dt=2024-01-01/part-0002
-- 但Hive让你用SQL访问
SELECT * FROM video_plays WHERE dt='2024-01-01';
-- 实际执行:Hive告诉Hadoop去HDFS的对应目录读取数据
2. 计算依赖关系
-- 你写一个复杂的聚合查询
SELECT
    video_id,
    COUNT(*) as play_count,
    AVG(duration) as avg_duration
FROM video_plays
WHERE dt BETWEEN '2024-01-01' AND '2024-01-07'
GROUP BY video_id
HAVING play_count > 1000
ORDER BY play_count DESC;
-- Hive把它翻译成:
-- Map阶段:读取数据,过滤日期,提取video_id和duration
-- Shuffle阶段:按video_id分组
-- Reduce阶段:计算COUNT和AVG,过滤HAVING,排序
-- 最终:在Hadoop集群上分布式执行
3. 元数据管理关系
-- Hive的Metastore存储"数据目录"
表video_plays:
  - 位置:hdfs://cluster/data/video/plays
  - 字段:video_id BIGINT, user_id BIGINT, ...
  - 分区:按dt分区
  - 格式:ORC格式
-- 但实际数据还是在HDFS上
-- Metastore只记"账本",HDFS才是"仓库"
四、工作流程:从SQL到结果的全过程
例子:统计每个视频的播放次数
-- 你的SQL
SELECT video_id, COUNT(*) as plays
FROM video_plays
WHERE dt='2024-01-01'
GROUP BY video_id;
执行流程:
步骤1: 【Hive接收SQL】
    ↓
步骤2: 【Hive解析器】检查语法,生成抽象语法树
    ↓
步骤3: 【Hive优化器】优化查询计划
     - 分区裁剪:只扫描 dt='2024-01-01' 的分区
     - 列裁剪:只读取 video_id 列
    ↓
步骤4: 【Hive执行器】生成MapReduce任务
     - Map任务:读取HDFS上/dt=2024-01-01/的数据
     - Reduce任务:按video_id分组计数
    ↓
步骤5: 【Hadoop YARN】调度任务
     - 分配Container运行Map任务
     - 分配Container运行Reduce任务
    ↓
步骤6: 【Hadoop HDFS】提供数据
     - Map任务从HDFS读取数据块
     - Reduce结果写回HDFS
    ↓
步骤7: 【Hive返回结果】给你
五、核心区别对比表
|
维度 |
Hadoop |
Hive |
关系 |
|---|---|---|---|
|
定位 |
分布式计算平台 |
数据仓库工具 |
Hive基于Hadoop |
|
编程语言 |
Java(MapReduce) |
SQL(HiveQL) |
Hive把SQL转成MapReduce |
|
使用难度 |
高(需写Java代码) |
低(会SQL即可) |
Hive降低了门槛 |
|
适用场景 |
通用计算框架 |
离线数据分析 |
Hive专注分析场景 |
|
执行速度 |
较慢(磁盘IO多) |
依赖于底层引擎 |
Hive on Spark更快 |
|
数据存储 |
HDFS直接存储 |
表形式管理HDFS数据 |
Hive是HDFS的"管家" |
|
元数据 |
无单独元数据 |
有Metastore管理 |
Hive维护数据目录 |
六、实际开发中的协作关系
大数据开发日常工作流:
# 1. 数据采集到HDFS(用Hadoop工具)
hadoop fs -put /local/logs/* /data/raw_logs/
# 2. 用Hive创建表,映射到HDFS数据
CREATE EXTERNAL TABLE raw_logs (...)
LOCATION '/data/raw_logs';
# 3. 用Hive SQL清洗转换数据
INSERT OVERWRITE TABLE clean_logs
SELECT * FROM raw_logs WHERE error_code = 0;
# 4. 用Hive做数据分析
SELECT user_id, COUNT(*) FROM clean_logs GROUP BY user_id;
# 5. 结果存回HDFS(供其他系统使用)
INSERT OVERWRITE DIRECTORY '/data/result'
SELECT ...;
现代大数据架构中的位置:
数据源
    ↓
[采集工具] → HDFS(原始数据存储)
    ↓
[Spark/Flink] ←→ Hive(数仓/即席查询) ←→ [数据分析师]
    ↓
[可视化工具] ← 结果数据
七、面试高频问题与回答
Q1: Hadoop和Hive是什么关系?
完整回答:
"Hadoop是底层的大数据计算和存储平台,包含HDFS和MapReduce等核心组件。Hive是建立在Hadoop之上的数据仓库工具,它提供了SQL接口,让用户可以用写SQL的方式操作HDFS上的数据,而不用写复杂的MapReduce程序。简单说,Hive是Hadoop的‘翻译官’和‘好帮手’。"
Q2: 既然有Hive,为什么还要用Hadoop?
标准回答:
"Hive依赖于Hadoop,它自己不存储数据(数据在HDFS),也不进行计算(计算由MapReduce/Spark执行)。Hive只做三件事:1)提供SQL接口;2)管理元数据;3)将SQL翻译成计算任务。Hadoop才是真正的‘干活的’,提供分布式存储和计算能力。"
Q3: 什么时候用Hive,什么时候用MapReduce?
场景化回答:
"用Hive的场景:需要快速做数据查询、统计、分析,业务逻辑能用SQL表达,对开发效率要求高,对延迟不敏感(分钟/小时级)。
用MapReduce的场景:需要高度定制化计算逻辑,性能要求极高,或者Hive不支持的特殊处理。但实际中,大部分Hive任务底层还是转成MapReduce执行。"
Q4: 既然Spark更快,为什么还要用Hive?
理性回答:
"Hive on Spark很常见!Hive和Spark不是二选一。Hive是接口层和元数据管理层,Spark是计算引擎层。我们可以用Hive管理表结构、分区、权限,用Spark做计算。而且Hive的SQL兼容性更好,生态工具更多。现在很多公司是‘Hive Metastore + Spark计算’的架构。"
八、影视飓风场景实例
场景:分析视频播放数据
没有Hive的时代:
// 要写几十行MapReduce代码
public class VideoAnalysis {
    public static class Map extends Mapper<...> {
        public void map(...) {
            // 解析日志行
            // 提取video_id
            // 输出(video_id, 1)
        }
    }
    public static class Reduce extends Reducer<...> {
        public void reduce(...) {
            // 累加计数
            // 输出结果
        }
    }
    // 还要main方法、打包、提交作业...
}
有Hive的时代:
-- 只需要一行SQL!
SELECT video_id, COUNT(*) as plays
FROM video_plays
WHERE dt='2024-01-01'
GROUP BY video_id;
实际工作流:
-- 1. 原始日志在HDFS
hdfs://cluster/logs/video_play/2024/01/01/*.log
-- 2. 用Hive建表
CREATE EXTERNAL TABLE video_plays (...)
PARTITIONED BY (dt STRING)
LOCATION 'hdfs://cluster/logs/video_play';
-- 3. 添加分区
ALTER TABLE video_plays ADD PARTITION (dt='2024-01-01');
-- 4. 直接分析
SELECT * FROM video_plays WHERE dt='2024-01-01' LIMIT 10;
九、一句话记忆要点
要记住的3个核心:
-
Hive是接口,Hadoop是引擎(就像方向盘和发动机)
-
Hive用SQL,Hadoop用Java(Hive翻译SQL给Hadoop执行)
-
数据在HDFS,元数据在Metastore(Hive知道数据在哪,怎么读)
面试时可以说:
"在我的理解中,Hadoop提供了大数据处理的‘基础设施’(HDFS存数据,YARN管资源,MapReduce做计算),而Hive是建立在它之上的‘数据仓库工具’,让我能用熟悉的SQL进行数据分析,大大降低了大数据的使用门槛。现代架构中,Hive常和Spark结合,Hive负责表管理和SQL解析,Spark负责高性能计算。"
实际工作流:
数据分析师写SQL → Hive接收并优化 → 生成计算任务 →
YARN调度资源 → MapReduce/Spark执行 → 从HDFS读写数据 →
结果返回给用户
✅ 总结:一张图搞定关系
┌─────────────────────────────────────────────┐
    │           数据分析师/大数据开发               │
    │                 写SQL查询                    │
    └─────────────────────────────────────────────┘
                        ↓
    ┌─────────────────────────────────────────────┐
    │                    Hive                     │
    │      把SQL翻译成分布式计算任务                │
    │  ┌─────────────────────────────────────┐  │
    │  │  Metastore: 知道数据在哪、什么结构    │  │
    │  │  HiveQL: SQL方言                     │  │
    │  │  驱动层: 解析-优化-执行                │  │
    │  └─────────────────────────────────────┘  │
    └─────────────────────────────────────────────┘
                        ↓
    ┌─────────────────────────────────────────────┐
    │                  Hadoop                     │
    │  ┌─────────────────────────────────────┐  │
    │  │  HDFS: 实际存储数据文件              │  │
    │  │  YARN: 分配CPU/内存资源               │  │
    │  │  MapReduce/Spark: 执行计算任务        │  │
    │  └─────────────────────────────────────┘  │
    └─────────────────────────────────────────────┘
简单说:Hadoop是地基和钢筋,Hive是精装修的房子。你不需要关心地基怎么打(分布式计算细节),只需要关心房子怎么住(写SQL分析数据)。
理解了这些,你就明白了为什么企业既要Hadoop又要Hive,以及它们如何协同工作支撑大数据分析!
© 版权声明
文章版权归作者所有,未经允许请勿转载。