
AI 应用层革命(一)——软件的终结与智能体的崛起
AI应用层革命正在颠覆传统软件范式。随着AI智能体(如ChatGPT、AutoGPT等)的崛起,人类交互方式从"命令"转向"意图"...

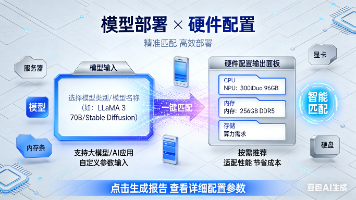
OpenClaw(养龙虾) +关于Hadoop hive的Skills(CLoudera CDH、CDP)
摘要:OpenClaw生态未内置Hadoop/Hive专用技能,因其企业级特性难以通用化。建议通过组合基础技能实现操作:1)使用tmux/session-logs管理长时任务;2)通过shell/ex...
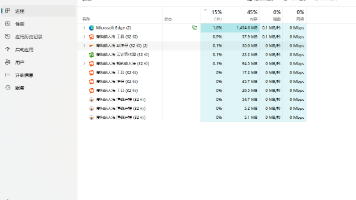
被搜狗输入法背刺了!偷偷装的 “AI 汪仔” 狂占 CPU!手把手教你如何彻底关闭删除搜狗AI功能AI汪仔
手把手教你如何彻底关闭删除搜狗输入法的AI汪仔🚀
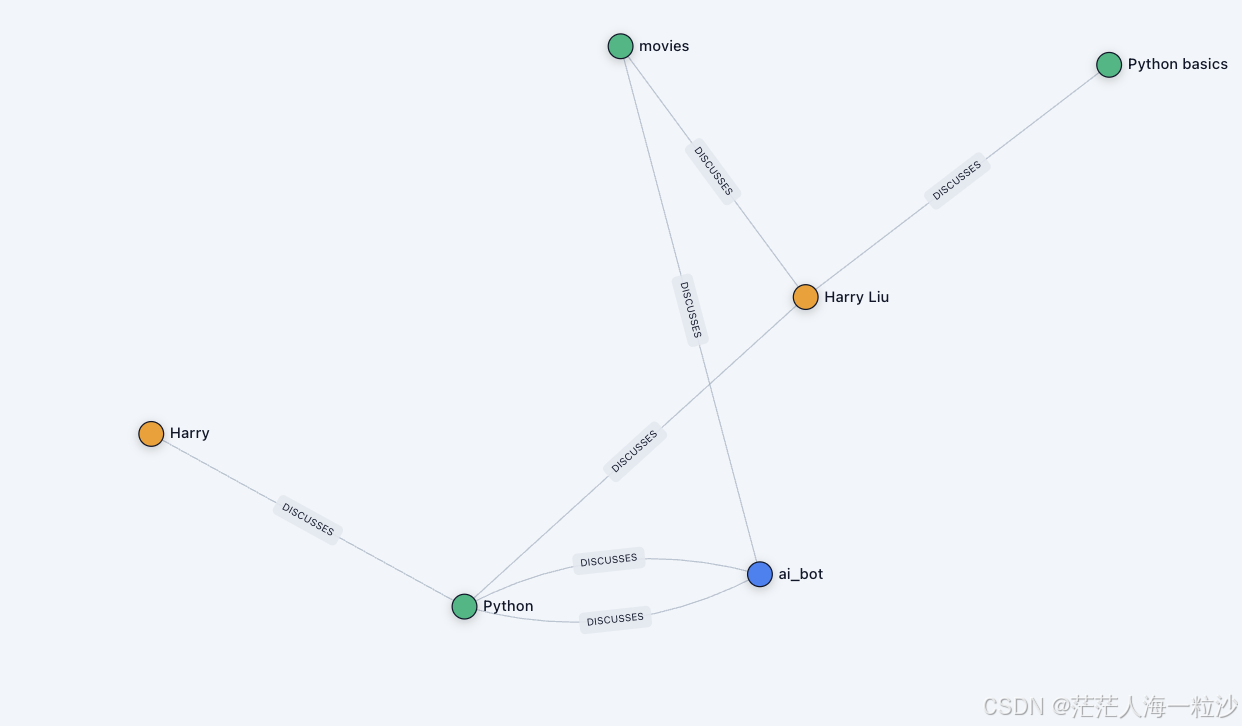
给 AI 装上长期记忆:Zep Cloud 初探与上手教程
传统的聊天机器人往往是「短期记忆」:只记住本轮对话内容。而 Zep 则进一步赋予 AI 「长期记忆」:它能管理用户信息、保存对话线程、抽取知识图谱,并支持高效的检索和推理。对于想要打造真正个性化 AI...

Spark-Submit参数介绍及任务资源使用测试
yarn-client模式中,通过指定“--num-executors”参数则默认为Spark任务启动2个Executor;提交任务后,可以通过WebUI查看当前Application使用资源情况:A...
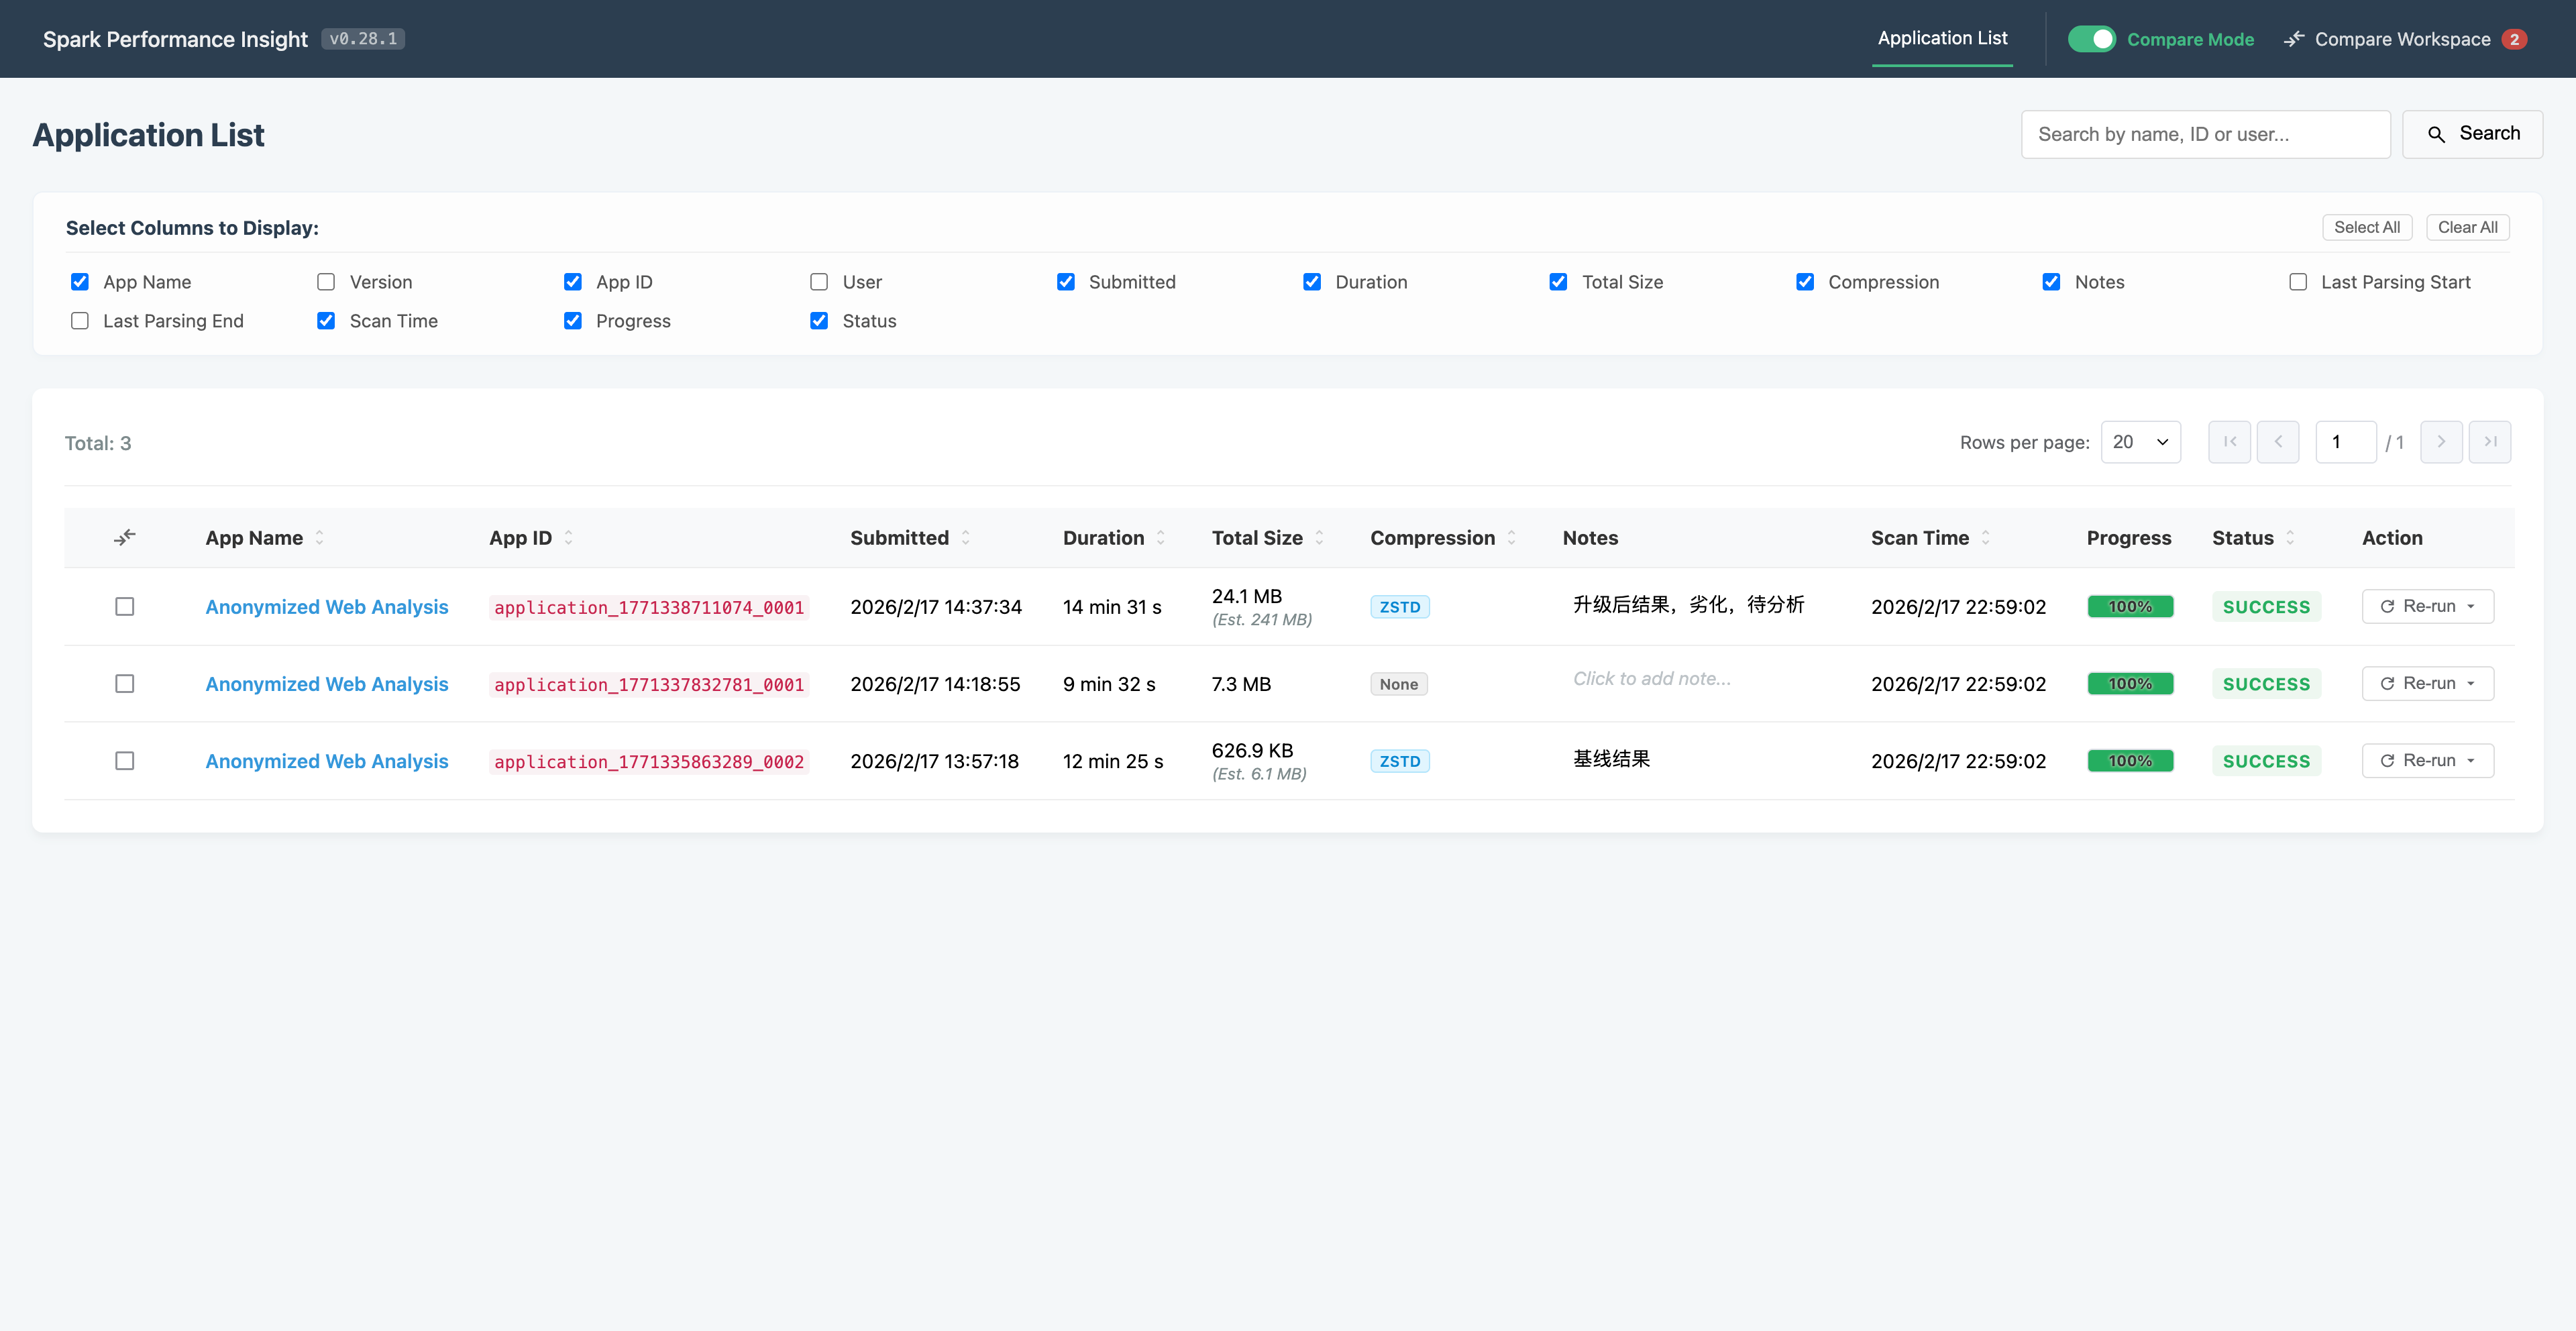
从“吐槽”到“交付”——我是如何协同 AI 撸出一个 Spark 性能分析工具的(上)
本文记录了一位后端开发者利用AI协作在3周内完成Spark性能分析工具开发的真实经历。通过"吐槽驱动开发"模式,作者实现了三大突破:跨越10年前端技术断层、24倍性...
【Filebeat+Kafka+ELK企业级日志系统实战部署:详解Kafka、Filebeat核心知识与ELK集成场景,Kafka集群部署、组件配置与验证,Filebeat部署及Kibana可视化】
本文介绍在ELK系统中加入Kafka和Filebeat的部署方案。Kafka作为高吞吐量消息队列,实现日志缓冲和削峰填谷;Filebeat作为轻量级日志采集工具,负责实时采集并转发日志至Kafka。文...
大数据领域的分布式文件系统
在大数据时代,数据量呈现爆炸式增长,传统的文件系统难以满足大规模数据存储和高效访问的需求。分布式文件系统应运而生,它将数据分散存储在多个节点上,通过网络进行统一管理和访问,提高了数据的可靠性、可扩展性...
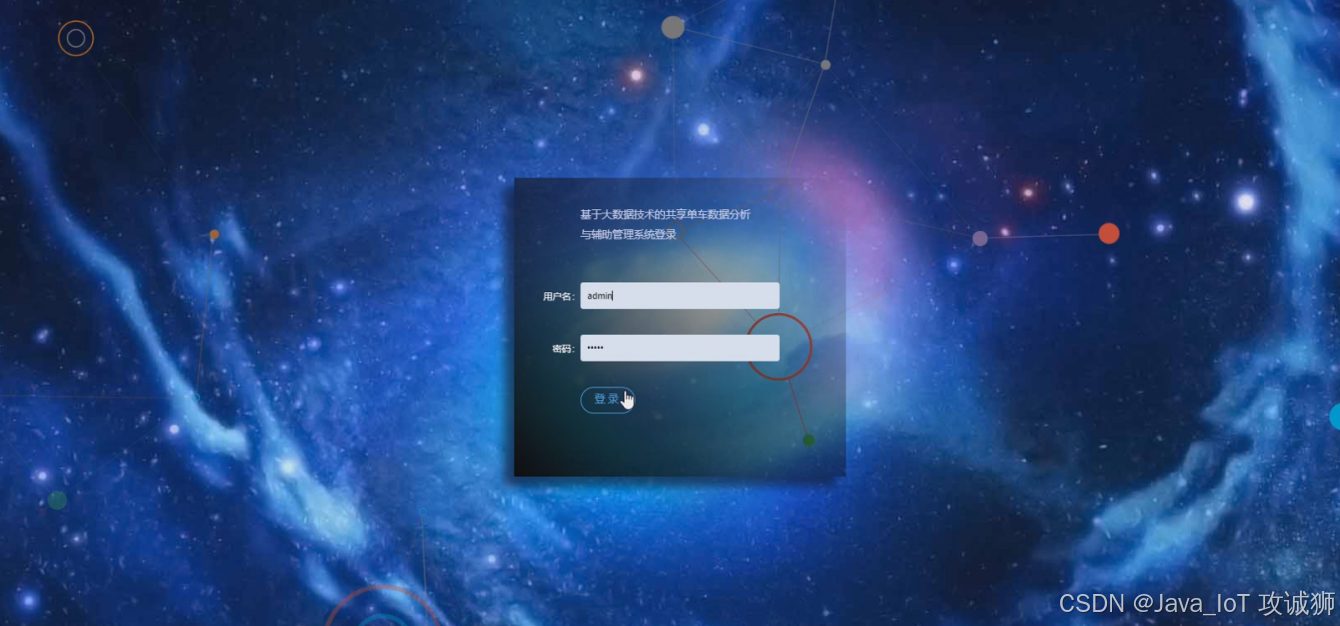
Python大数据可视化:基于大数据技术的共享单车数据分析与辅助管理系统_flask+hadoop+spider
在搭建过程中,最开始的工作是从查阅相关资料开始的,通过在互联网的共享单车数据分析与辅助管理系统资料查询和阅读,对整个共享单车数据分析与辅助管理系统有了整体的概念了解,然后对本共享单车数据分析与辅助管理...
基于Python大数据旅游数据分析与推荐系统的爬虫 数据分析可视化系统
该系统基于Python技术栈构建,整合了网络爬虫、大数据分析、机器学习推荐算法及可视化技术,旨在为旅游行业提供数据驱动的决策支持与个性化服务。数据采集层采用Scrapy框架爬取主流旅游平台(如携程、T...