【大数据处理与分析】Hadoop在探讨:04 Hadoop生态系统中具有代表性的功能组件 Pig简化批处理编程;Tez优化DAG作业提升效率;Kafka作为高吞吐消息枢纽,连接Hadoop与多种专用系统,实现数据高效交换。三者分别解决开发效率、计算性能和数据流转问题。 国内服务器 2个月前350
HBase与Spark集成:大数据处理的黄金组合 随着企业数据量的指数级增长,单一技术已难以满足“实时存储+复杂计算”的双重需求:HBase擅长处理海量数据的随机读写与实时访问,但计算能力有限;Spark则以内存计算为核心,支持批处理、流处理、机器学... 国内服务器 2个月前270
大数据领域存算分离:架构解析与应用实践 随着企业数据量从TB级向EB级跃迁(例如某电商大促单日产生500TB日志),传统“存储与计算紧耦合”的架构(如Hadoop早期的HDFS+MapReduce)暴露出扩展性差、资源利用率低、成本高等问题... 国内服务器 2个月前300
如何选择最适合你的异步运行时:rust-rdkafka与smol、async-std集成实战指南 [特殊字符] rust-rdkafka 是一个基于librdkafka的完全异步、基于futures的Kafka客户端库,专为Rust语言设计。这个强大的库不仅支持默认的Tokio运行时,还提供了灵活的异步运行时集... 国内服务器 2个月前310
Miva:从Rust到新语言的蜕变之旅 文章摘要: 作者分享了设计编程语言Miva的历程,该语言受Rust启发但追求更简化的内存安全与灵活性。初期尝试用Rust实现编译器时遇到解析器(Parser)和语义分析(Semantic)的困难,后转... AI 2个月前320
露易丝·海的诗歌10 我行动的方式不同,别人对待我的方式也不同。因为我知道,这些种子会变成我新的生命经历。我生命中的每一刻都是新鲜又至关重要的。我用肯定积极的思维创造真正想要的生活。我思考的方式不同,我说话的方式不同,我满... AI 2个月前300
AI 生成前端 Mock 数据:先定义业务状态,再生成随机字段 AI 生成前端 Mock 数据时,先定义业务状态矩阵,再生成字段内容。覆盖正常、空、错、权限、边界和长文本等场景,并用类型或 schema 校验。Mock 数据不是越多越好,而是越能暴露界面问题越好... AI 2个月前460
AI 云原生后端架构:模型服务也要按高可用系统设计 AI 云原生后端架构应把模型服务当作高成本、高延迟、可能故障的核心依赖来设计。通过分层、超时、降级、弹性伸缩和可观测性,才能让 AI 能力稳定进入生产链路。 AI 2个月前400
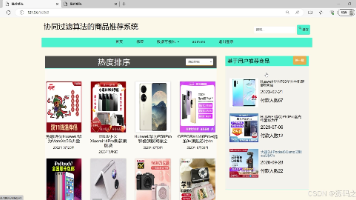
计算机毕业设计源码:双协同过滤商品推荐系统 Django 可视化 Bootstrap 人工智能 大数据 数据分析 推荐系统 agent 大模型 数据挖掘 deepseek(建议收藏)✅ 摘要 本项目开发了一个基于协同过滤算法的商品推荐系统,采用Python+Django技术栈构建。系统实现了基于用户和物品的双重协同过滤推荐算法,通过计算用户偏好相似度和商品关联度实现个性化推荐。主要功... 国内服务器 2个月前290