Workers AI 完整教程:每天白嫖 10000 次大模型调用,比 OpenAI 省 90% 完整 Workers AI 教程:零成本调用 Llama 3.1、Mistral 等开源大模型。每天 10,000 Neurons 免费额度,比 OpenAI API 节省 90% 成本。含完整代码示... AI 2个月前280
AI 任务调度引擎:大模型推理资源的智能分配与弹性伸缩 AI 任务调度引擎的核心目标是平衡延迟 SLA 与 GPU 资源利用率。三大核心机制——优先级调度防饿死、资源感知路由降成本、弹性伸缩提效率——各有适用场景和代价。冷启动延迟是弹性伸缩的最大制约,维持... AI 2个月前350
Kafka为什么抛弃ZooKeeper?深度解析KRaft时代的技术变革 KRaft(Kafka Raft)是Kafka基于Raft共识算法实现的内置元数据管理机制。它将原本存储在ZooKeeper中的元数据(主题、分区、ISR、配置等)迁移到Kafka自身的一个特殊日志主... 国内服务器 2个月前320
AI 调用链路追踪:一次回答背后可能有十几个后端节点 每个节点都应该有 span,记录耗时、输入规模和关键决策。比如检索 top_k、模型名、token 数量、是否命中缓存。AI 调用链路追踪要覆盖鉴权、Prompt、检索、重排、模型、安全、缓存和审计等... AI 2个月前310
AI 交互体验设计:从响应延迟到信任构建的体验工程实践 AI 产品的体验设计,核心在于管理用户对不确定性的感知。落地路线如下:第一,构建三层体验架构。感知层消除等待焦虑,理解层降低输出理解成本,信任层建立能力边界认知。三层递进,从"知道系统在做什... AI 2个月前350
AI 辅助:数据仓库从零搭建:指标体系比表结构更先行 下面是一个指标定义示例。name: 支付订单数filters:- city- channel- category指标定义要能被人读懂,也能被系统消费。公式、过滤条件、时间字段、维度、负责人、更新时间都... 国内服务器 2个月前280
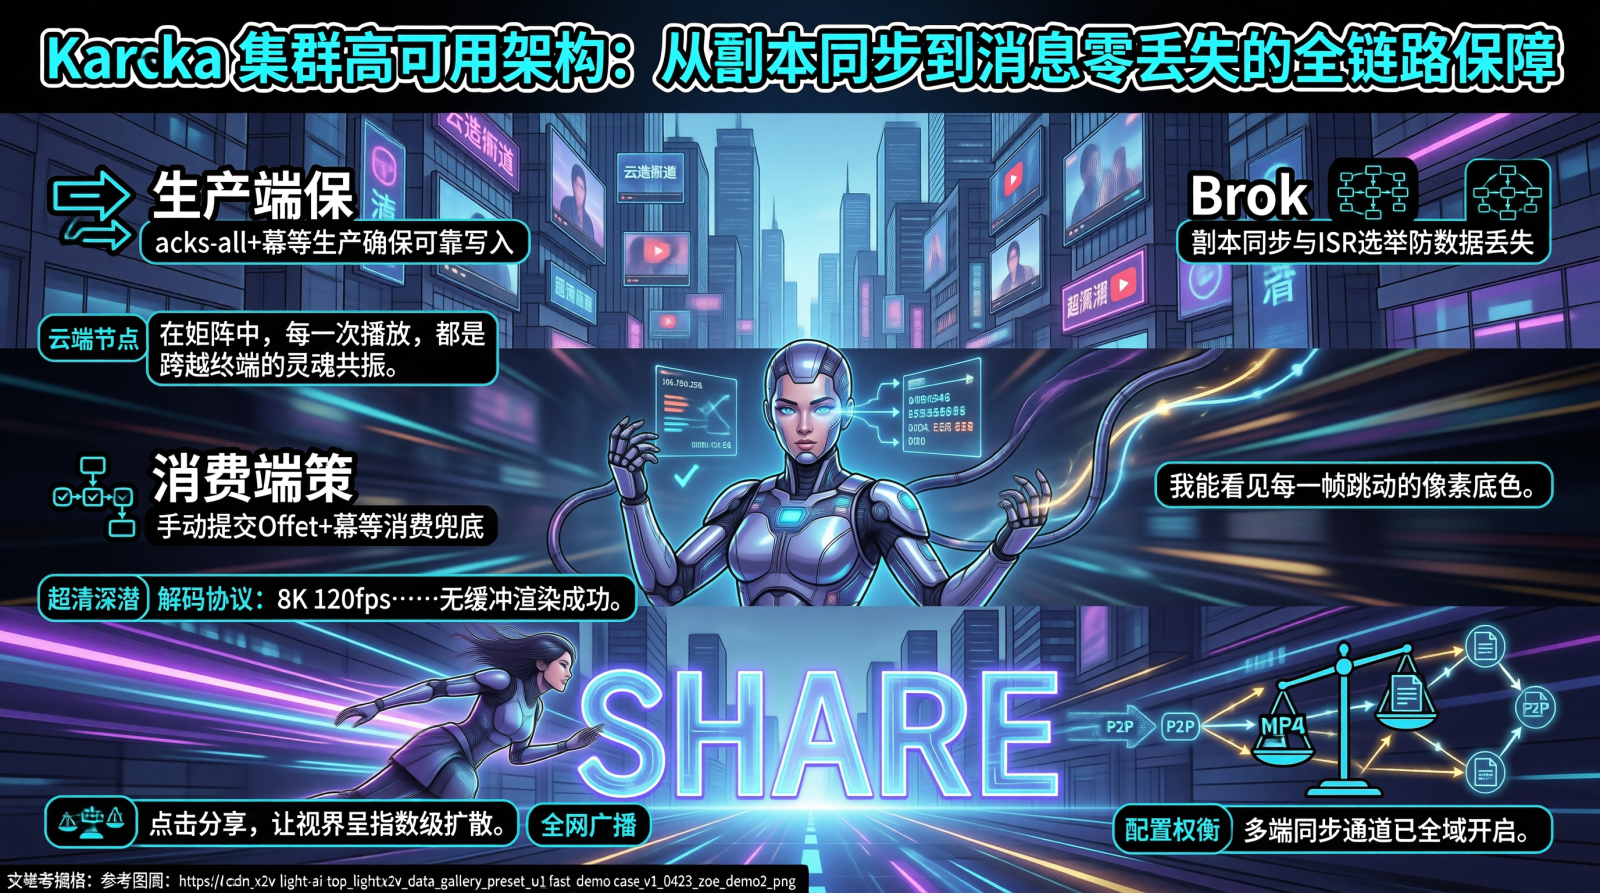
Kafka 集群高可用架构:从副本同步到消息零丢失的全链路保障 Kafka 消息零丢失需要三端协同保障:生产端使用acks=all+ 幂等生产确保消息可靠写入;Broker 端通过副本机制和 ISR 选举确保已提交消息不丢失;消费端通过手动提交 Offset 和幂... 国内服务器 2个月前290
Python 消息队列选型:从 Redis Stream 到 Kafka 的工程决策框架 消息队列选型的核心思路是“需求驱动选型,而非技术驱动选型”。低吞吐任务队列选 Redis Stream,复杂路由场景选 RabbitMQ,高吞吐事件流选 Kafka——每种队列都有其最优的适用场景。落... 国内服务器 2个月前330
AI Agent 系统设计:从单轮对话到多步推理的架构演进 AI Agent 系统将大模型从被动生成器升级为自主智能体,ReAct 范式提供了推理-行动-观察的核心循环框架,记忆架构解决了状态持久化问题,反思机制增强了系统的自我纠错能力。然而,Agent 系统... AI 2个月前270
AI会议与实时翻译 而实时翻译功能则打破了语言界限,支持多语种即时转换,跨国团队沟通时,发言人话音刚落,译文就同步呈现,不管是英语、日语还是小语种交流,都能实现“零延迟”理解。无需专业翻译在场,也能让不同语言背景的参会者... AI 2个月前320