【流处理架构升级指南】:为什么90%的系统都忽略了Kafka Streams的反应式适配能力? 掌握流处理架构升级核心方法,解析Kafka Streams反应式适配如何提升系统实时性与弹性。适用于高并发日志处理、事件驱动架构等场景,通过背压控制与非阻塞编程优化资源利用,实现高效稳定的数据处理,值... 国内服务器 9个月前880
毕业设计 基于大数据的社交平台数据爬虫舆情分析可视化系统 本文介绍了一个基于大数据的社交平台舆情分析可视化系统,主要实现了Twitter数据挖掘、实时热点话题检测、情感分析和可视化展示功能。系统采用LDA主题模型进行话题挖掘,通过预处理、特征提取和特征选择优... 国内服务器 9个月前850
智慧矿山和工业大数据解决方案“组态软件qSCADA” 在煤炭行业智能化转型进入深水区的当下,数据已成为驱动矿山安全生产、高效运营的核心生产要素。然而,行业普遍面临数据孤岛突出、多系统协同不畅、异构数据处理能力不足等痛点,严重制约了智能化升级的步伐。汇智信... 国内服务器 9个月前990
终极Kafka管理神器:Kafka-UI完全使用指南 还在为复杂的Kafka集群管理而头疼吗?Kafka-UI作为一款免费开源的Web界面工具,彻底改变了Apache Kafka的管理方式。这个轻量级但功能强大的工具让您能够直观地监控和管理Kafka集群... 国内服务器 9个月前1030
3分钟掌握Vue虚拟滚动列表:告别大数据渲染卡顿的终极方案 在当今数据驱动的应用开发中,处理海量列表数据已成为前端开发者的日常挑战。当面对成千上万条数据需要渲染时,传统列表组件的性能瓶颈暴露无遗,页面卡顿、内存溢出等问题频发。而vue-virtual-scro... 国内服务器 9个月前940
计算机大数据毕业设计hadoop+spark+hive电商数据分析大屏可视化推荐系统 大数据毕业设计(源码+LW+PPT+讲解) 本文介绍了基于Hadoop+Spark+Hive的电商数据分析大屏可视化推荐系统。系统整合用户行为、商品和供应链等多源数据,通过混合推荐算法(协同过滤+内容推荐+图神经网络)提升推荐准确率,并实现实时... 国内服务器 9个月前900
大数据新视界 — Impala 性能优化:分布式环境中的优化新视野(下)(28 / 30) 本文聚焦分布式环境下 Impala 性能优化。深入剖析数据传输开销与节点资源竞争对查询性能影响,详述数据布局优化(分区策略、数据本地化)与资源管理优化(动态资源分配、查询队列管理)策略,并以互联网金融... 国内服务器 9个月前760
三、Spark 运行环境部署:全面掌握四种核心模式 部署Spark就像选择不同的道路,从用于学习的Local“院子”,到独立的Standalone“专线”,再到与Hadoop集成的YARN“高速网”,而Windows本地开发则需先搞定特殊的winuti... 国内服务器 9个月前960
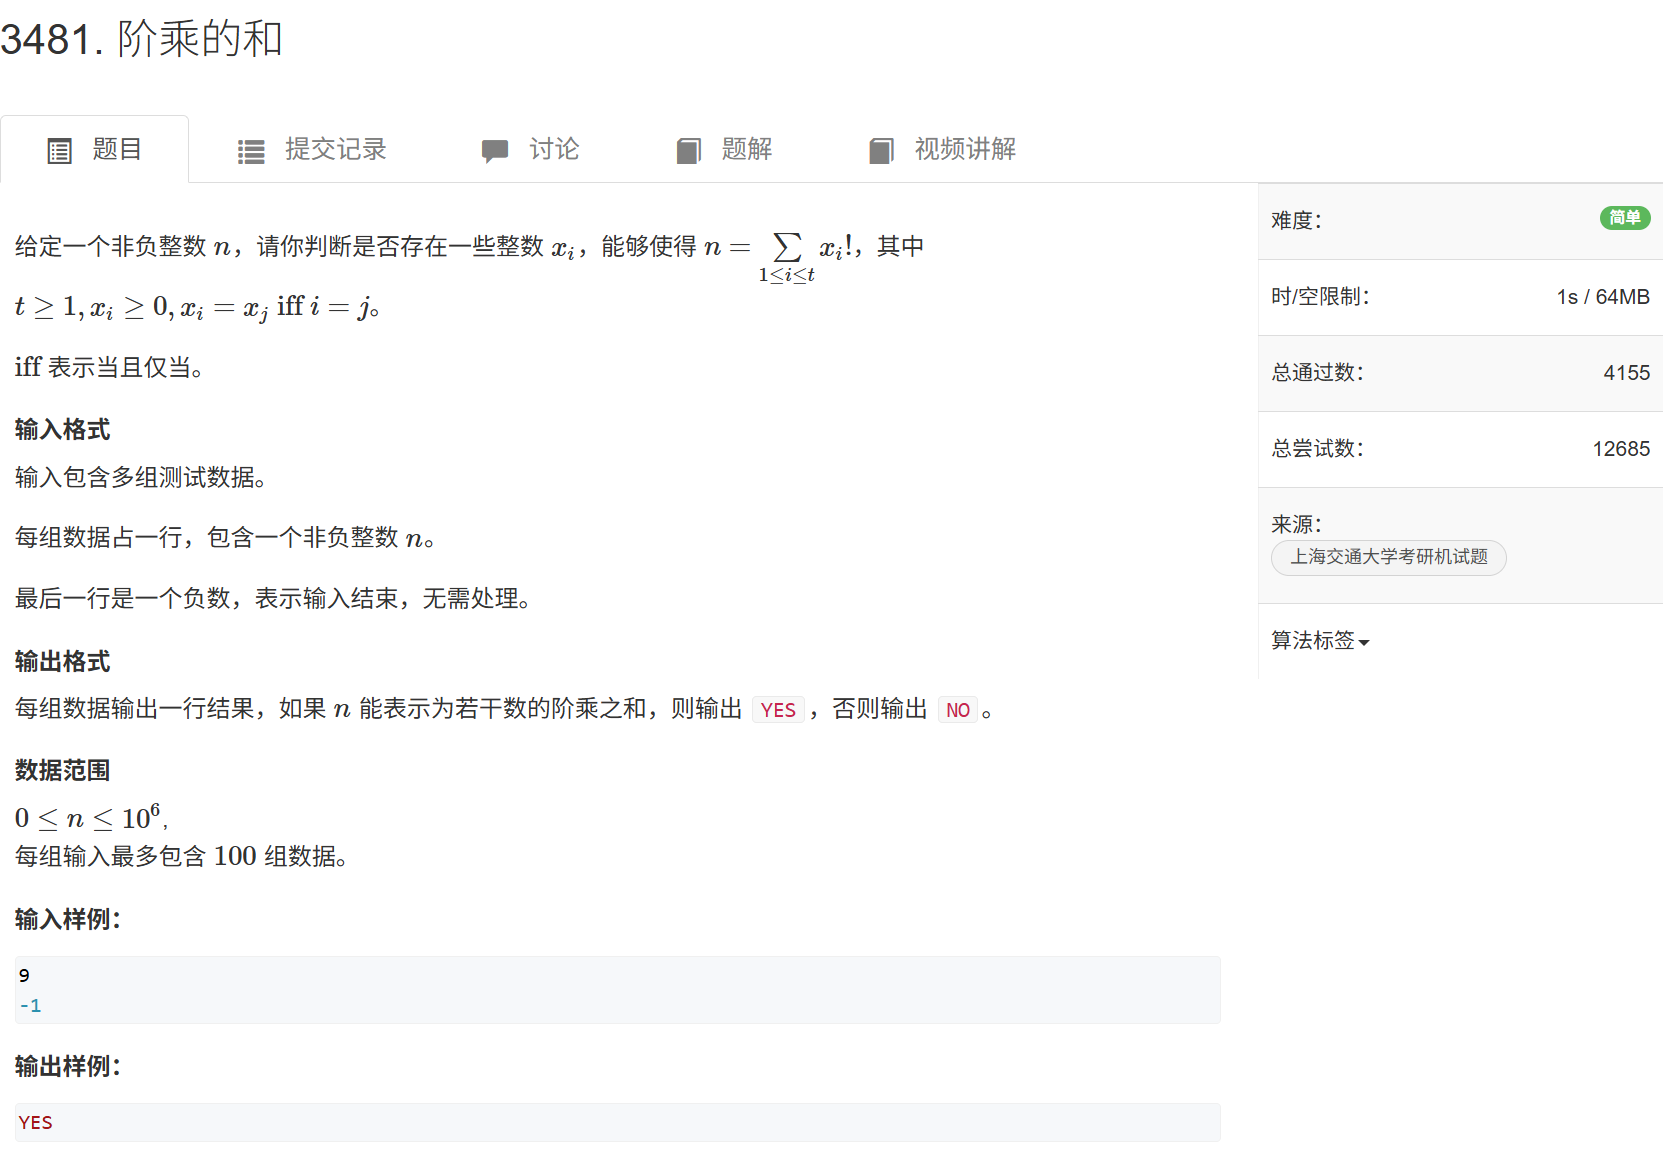
3481.阶乘的和 1、先初始化一个set(作用是使阶乘之和不重复),初始数据是{0}(0的作用是计算1!所以考虑一个数能否由几个数的阶乘组成,我们可以先计算所有可能的阶乘之和,用空间换时间。4、由于题目要求至少有一个数... 国内服务器 9个月前930
【TextIn大模型加速器 + 火山引擎】用Coze+TextIn+飞书搭建智能合同审查工作流 合同审查AI工作流通过TextIn+Coze+飞书技术栈实现法务自动化。该方案利用TextIn的高精度文档解析能力(支持PDF/图片等10+格式,95%准确率),结合Coze低代码平台搭建智能审查流程... AI 9个月前1370