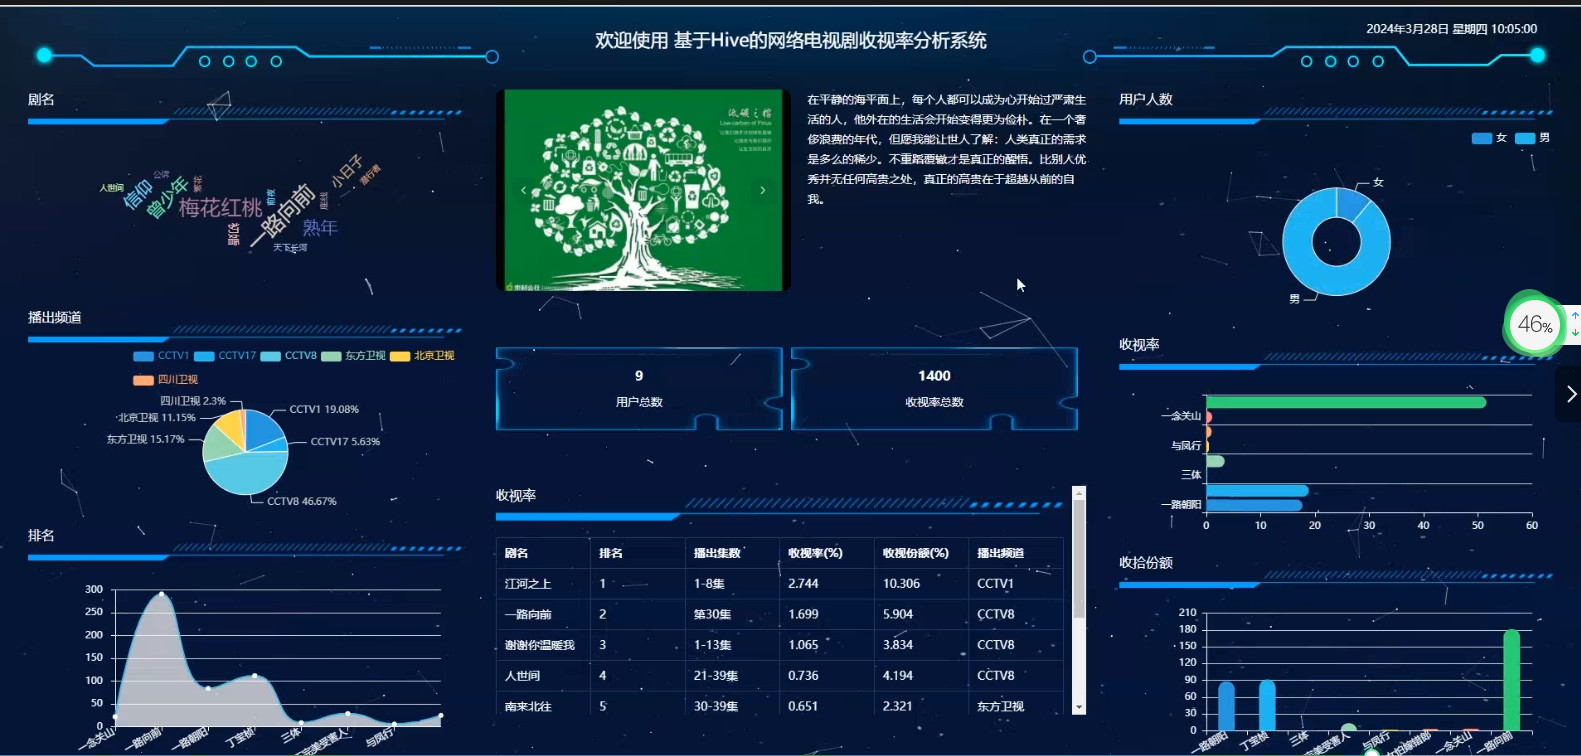
基于大数据爬虫+SpringBoot+Hive的网络电视剧收视率分析与可视化平台系统(源码+论文+PPT+部署文档教程等) 摘 要在当今数字化时代,网络电视剧作为一种新兴的娱乐形式,受到了广泛的关注和欢迎。随着网络电视剧市场的不断扩大和竞争的加剧,各大卫视平台纷纷推出了大量优质的网络电视剧,努力吸引观众和提升收视率。然而... 国内服务器 7个月前980
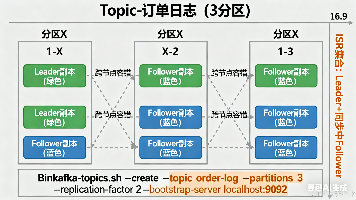
【分布式利器:Kafka】1、Kafka 入门:Broker、Topic、分区 3 张图讲透(附实操命令) 摘要:本文通过快递网点、分类筐和小格子的生动比喻,直观解析Kafka三大核心概念。Broker是存储转发消息的物理服务器节点,Topic是逻辑消息分类容器,分区则是实现并行处理的最小单元。文章提供可视... 国内服务器 8个月前980
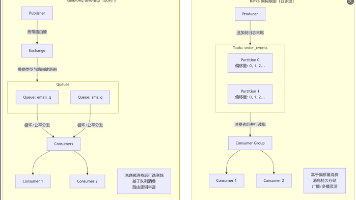
【终极对决】Kafka vs RabbitMQ:深入剖析消息中间件双雄,附选型指南与代码实战 Kafka vs RabbitMQ:消息中间件选型指南 本文深入对比了两大主流消息中间件: 架构差异: RabbitMQ采用交换器-队列模型,擅长消息路由与可靠投递 Kafka基于分布式日志设计,专注... 国内服务器 8个月前980
windows Hive使用全攻略:从入门到实战,轻松搞定大数据处理 – Hadoop windows安装 本文介绍了Hive在大数据生态中的核心作用及其典型应用场景。Hive作为基于Hadoop的数据仓库工具,通过类SQL语言(HQL)降低大数据处理门槛,适用于数据仓库构建、海量数据分析、用户行为分析等场... 国内服务器 7个月前970
【大数据基础】大数据处理架构Hadoop:02 Hadoop生态系统 本文讲解Hadoop生态系统,涵盖HDFS、HBase等众多组件。它们各司其职,协同运作,在数据存储、处理、分析、协同及管理等方面发挥优势,为大数据应用提供全面支撑。 国内服务器 8个月前970
计算机毕业设计hadoop+spark+hive地铁预测可视化 智慧轨道交通系统 大数据毕业设计(源码+文档+PPT+讲解) 本项目基于Hadoop+Spark+Hive构建地铁客流量预测系统,采用四层架构实现数据采集、存储处理、分析预测和可视化展示。核心功能包括:通过Flume采集多源数据(日均500万条),使用Hive构... 国内服务器 8个月前970
Flutter for OpenHarmony:hive_flutter — 极致性能的纯 Dart 本地数据库 摘要: Hive作为纯Dart实现的NoSQL数据库,是鸿蒙(OpenHarmony)应用本地持久化的高效解决方案。其核心优势包括毫秒级查询(基于内存索引)、支持AES加密及适配鸿蒙沙箱环境。通过Bo... 国内服务器 6个月前960
AI大模型的本质:基于大数据的拟合 摘要:AI大模型的本质是基于海量数据的高维非线性拟合系统,而非真正的智能涌现。从线性回归到千亿参数的大模型,其核心机制始终是统计概率预测,而非理解或创造。大模型通过自动补全模式生成看似智能的文本,但无... 国内服务器 7个月前960
Canal用RabbitMQ来监听MySQL详细配置及问题解决 本文详细记录了在Windows环境下配置Canal 1.1.7版本与MySQL、RabbitMQ集成的全过程。文章特别强调了配置中的关键点和常见问题,如需要手动添加RabbitMQ队列和路由键配置、确... 国内服务器 8个月前960