数睿通2.0升级:支持docker一键部署,升级flink版本,更新操作手册,优化数据开发、数据权限 更快把环境搭起来:系统包 + 组件包按需组合,一键跑通核心流程;更顺畅地接入业务系统:业务库新增 PostgreSQL / Kingbase 兼容支持;更放心地把作业跑起来:Flink 1.18/2... 国内服务器 7个月前820
Elasticsearch 8.16.0:革新大数据搜索的新利器 BBQ)是中一种开创性的向量数据量化方法。它的核心目标是在提高向量数据压缩率的同时,维持高召回率,并提供自定义选项。其原理是通过巧妙地结合标量量化和位向量支持来实现这一目标。在实际的数据处理中,向量数... 国内服务器 8个月前820
数据湖的崛起:从大数据到智能未来的钥匙 随着2025年数据湖技术的成熟,企业正通过这一新型架构解锁海量数据的价值。本文将深入解析数据湖的技术核心、行业应用与中国市场实践,探讨其如何成为AI时代的核心引擎。 国内服务器 8个月前820
大数据领域中Eureka与其他技术的融合应用 大数据系统的本质,是分布式组件的协同网络计算层:Spark、Flink、Presto等任务节点动态扩容;存储层:HDFS、HBase、S3等存储节点弹性伸缩;管道层:Kafka、CDC、Flume等消... 国内服务器 8个月前820
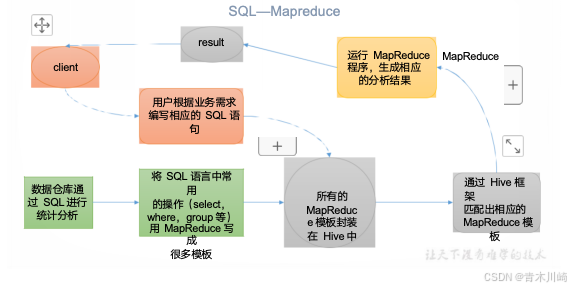
大数据技术之hive Hive:由 Facebook 开源用于解决海量结构化日志的数据统计工具。Hive 是基于 Hadoop 的一个数据仓库工具,可以将结构化的数据文件映射为一张表,并提供类SQL查询功能。创建一个数据库... 国内服务器 4个月前810
Kafka – 环境搭建保姆级教程(Windows/Linux/Mac通用) Kafka环境搭建指南 本文提供一份详细的Kafka环境搭建教程,适用于Windows、Linux和macOS系统。主要内容包括: 准备工作:确认系统支持情况,安装Java环境(推荐JDK 11/17... 国内服务器 5个月前810
小红书面试真题-Kafka持久化机制与ISR原理 本文深入解析Kafka持久化机制与ISR原理。Kafka采用顺序写磁盘和分段存储设计,通过零拷贝技术实现高吞吐,完美适配小红书海量日志场景。ISR机制通过同步副本集合保证消息可靠性,包含Leader和... 国内服务器 6个月前810
二、Kafka核心架构与分布式存储 在大数据与流式计算场景中,Kafka逐渐成为核心的数据传输基础设施。作为分布式事件流平台,它通过分区、副本与Broker集群实现高吞吐和高可靠的数据处理。理解Kafka的架构逻辑,需要结合HDFS等分... 国内服务器 6个月前810
你活在“人工智能”得造梦里吗? 从简单的自用工具被AI 把常规思路链 慢慢拓宽 把从“1”变成了“一”。但是AI不知道 什么是时间节点,什么是“过时”。如今的“社会”脚步飞快,眼睛眨一下就好像被整个"世界给弃用” 具统计百... 国内服务器 7个月前810