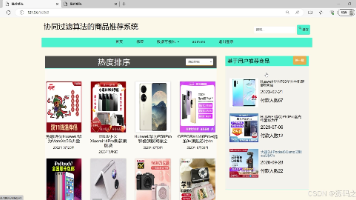
计算机毕业设计源码:双协同过滤商品推荐系统 Django 可视化 Bootstrap 人工智能 大数据 数据分析 推荐系统 agent 大模型 数据挖掘 deepseek(建议收藏)✅ 摘要 本项目开发了一个基于协同过滤算法的商品推荐系统,采用Python+Django技术栈构建。系统实现了基于用户和物品的双重协同过滤推荐算法,通过计算用户偏好相似度和商品关联度实现个性化推荐。主要功... 国内服务器 2个月前290
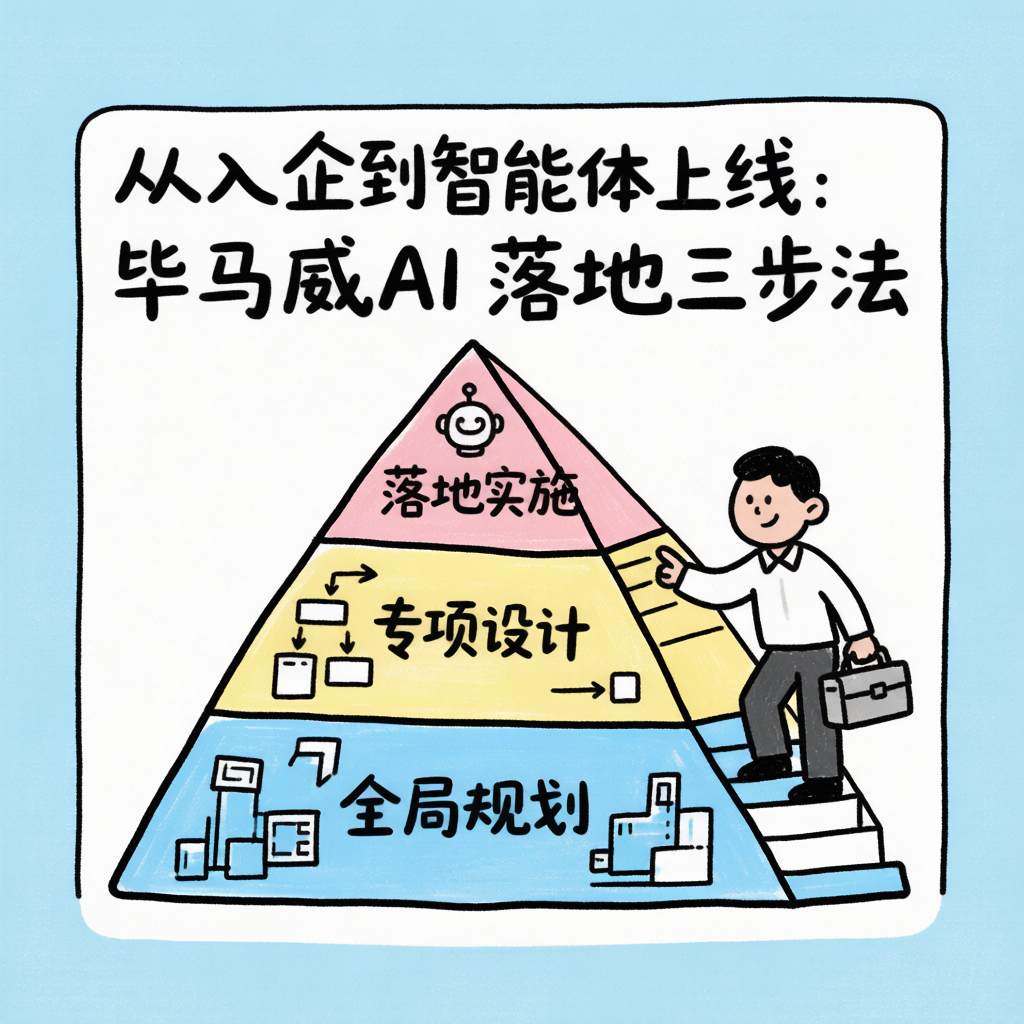
毕马威《2026全球技术报告》披露:AI 落地的三步法与 FDE 双轮驱动 AI 落地最难的部分,从来不是模型本身。难的是场景定义——能不能把"我们要用 AI"拆成一张张场景定义卡片;难的是流程再造——能不能根据风险等级为每个节点设计最合适的人机协同模式... 国内服务器 2个月前430
3.3 国内数据治理发展:从国家大数据战略到 DCMM 评估,中国数据治理的黄金十年 中国数据治理的发展,走了一条自上而下、政策引领、评估驱动的高效之路。从 2015 年大数据战略启航,到 2020 年数据跻身生产要素,再到《数据二十条》奠定制度基石,最后通过 DCMM 让治理可量化... 国内服务器 2个月前310
Flume与流处理框架集成实践:从Storm到Flink的架构演进 采集层(Flume):多源接入、事务保证、可靠传输缓冲层(Kafka):削峰填谷、多订阅、持久化保障处理层(Storm/Flink):实时计算、状态管理、复杂事件处理架构演进趋势Storm → Fli... 国内服务器 2个月前280
Kubernetes Job 跑批推理:完成任务比常驻服务更重要 Kubernetes Job 适合离线 AI 跑批推理。关键是区分在线离线任务,设计幂等输入、合理资源申请、并发控制、结果存储和失败样本管理。不是所有推理都要常驻服务。对跑批任务来说,稳定完成、可恢复... 国内服务器 2个月前370
深入解析机器人开发的基石:掌握Catkin编译系统的结构精髓 Catkin编译系统是ROS机器人开发的核心构建工具,通过三层架构解决多模块管理难题:声明层(package.xml定义元数据)、构建规则层(CMakeLists.txt配置编译规则)和系统支撑层(依... 国内服务器 2个月前380
AI部署搭建选型,隐性约束比硬件配置更值得关注 不同行业对数据留存和安全审计的要求不同,金融、医疗、政务等项目通常对数据留存周期、权限管理、安全审计和等级保护有更严格要求,这些要求直接决定了部署形态的选择。实际操作中,一个完整的智能体链路涉及数据采... 国内服务器 2个月前390
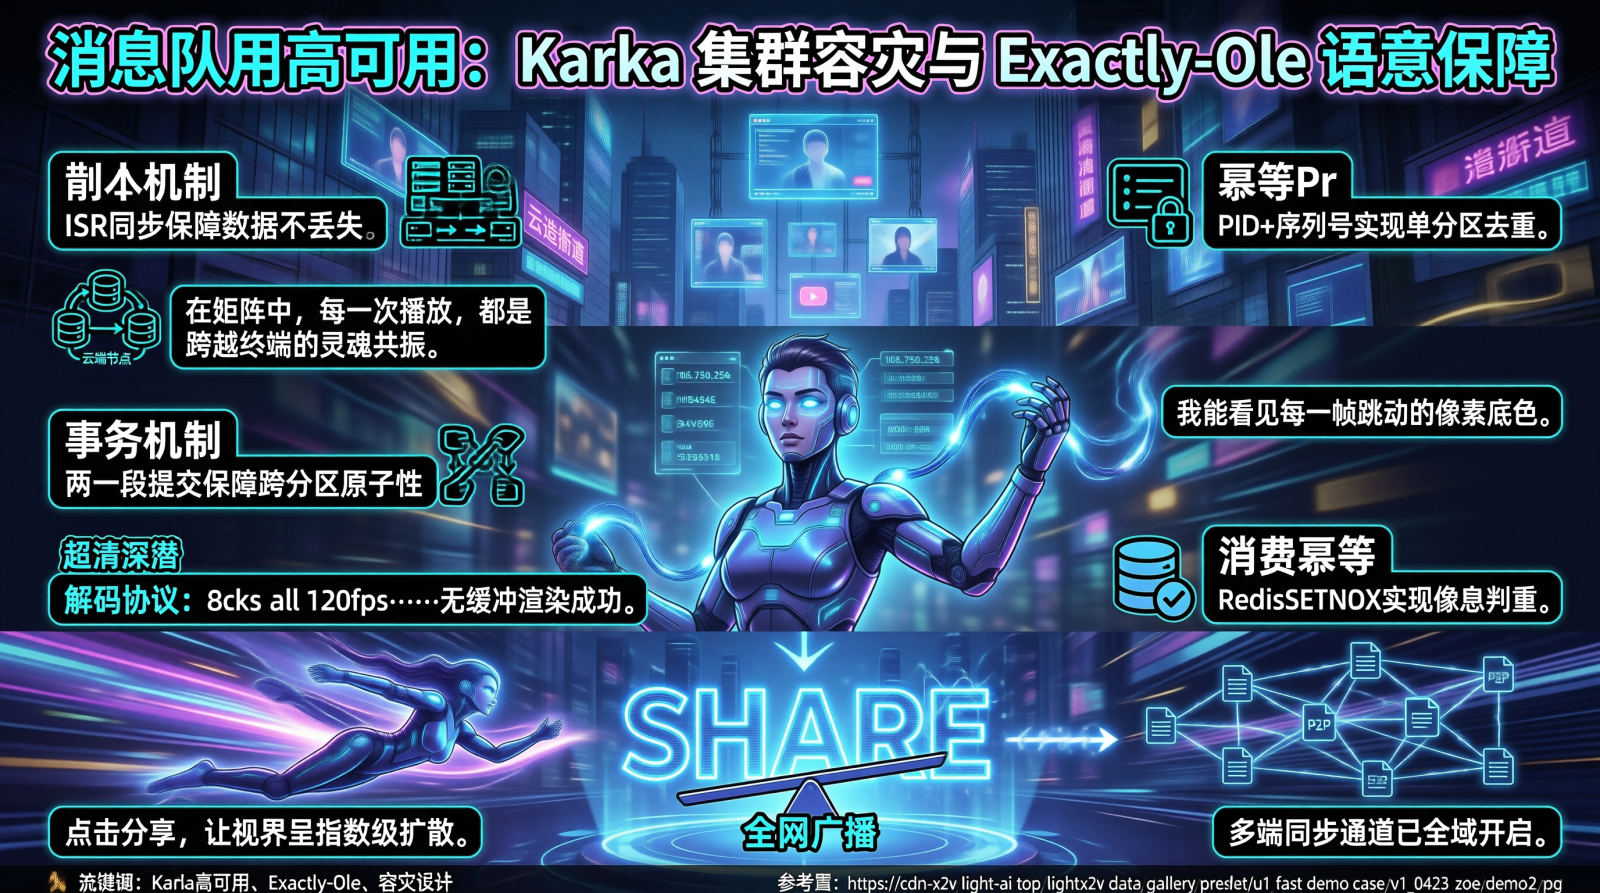
消息队列高可用:Kafka 集群容灾与 Exactly-Once 语义保障 Kafka 的高可用建立在副本机制之上,Exactly-Once 语义依赖幂等性 Producer 和事务机制的协同。但消息的"不丢不重"不能仅靠 Kafka 自身保障,必须从 P... 国内服务器 2个月前320
计算机毕业设计PySpark+SparkML+Kafka+Hive深圳智慧交通预警系统 交通拥堵预测决策 智慧交通大数据可视化 大数据毕业设计(源码+LW+PPT+讲解) 本设计基于 PySpark、SparkML、Kafka、Hive 搭建深圳智慧交通预警可视化平台。依托 Hive+HDFS 搭建数据仓库存储路网 CSV 数据,Kafka 采集实时车流;通过 PySp... 国内服务器 2个月前230