Hadoop distcp 命令详解:高效跨集群数据复制 distcp是 Hadoop 生态中不可或缺的数据迁移工具。理解其选项含义,尤其是并行度、分块传输、增量更新、跳过校验、直接写入等关键参数,能让你在面对 PB 级数据复制任务时游刃有余。合理调优,不仅... 国内服务器 2个月前360
Spark.NET自定义服务注册:扩展框架功能的完整教程 Spark.NET是一个功能强大的.NET全栈Web应用框架,它提供了优雅的服务注册机制来简化依赖注入配置。本文将为您详细介绍如何在Spark.NET中进行自定义服务注册,扩展框架功能,并创建可重用的... 国内服务器 2个月前310
Kafka为什么抛弃ZooKeeper?深度解析KRaft时代的技术变革 KRaft(Kafka Raft)是Kafka基于Raft共识算法实现的内置元数据管理机制。它将原本存储在ZooKeeper中的元数据(主题、分区、ISR、配置等)迁移到Kafka自身的一个特殊日志主... 国内服务器 2个月前320
AI 辅助:数据仓库从零搭建:指标体系比表结构更先行 下面是一个指标定义示例。name: 支付订单数filters:- city- channel- category指标定义要能被人读懂,也能被系统消费。公式、过滤条件、时间字段、维度、负责人、更新时间都... 国内服务器 2个月前280
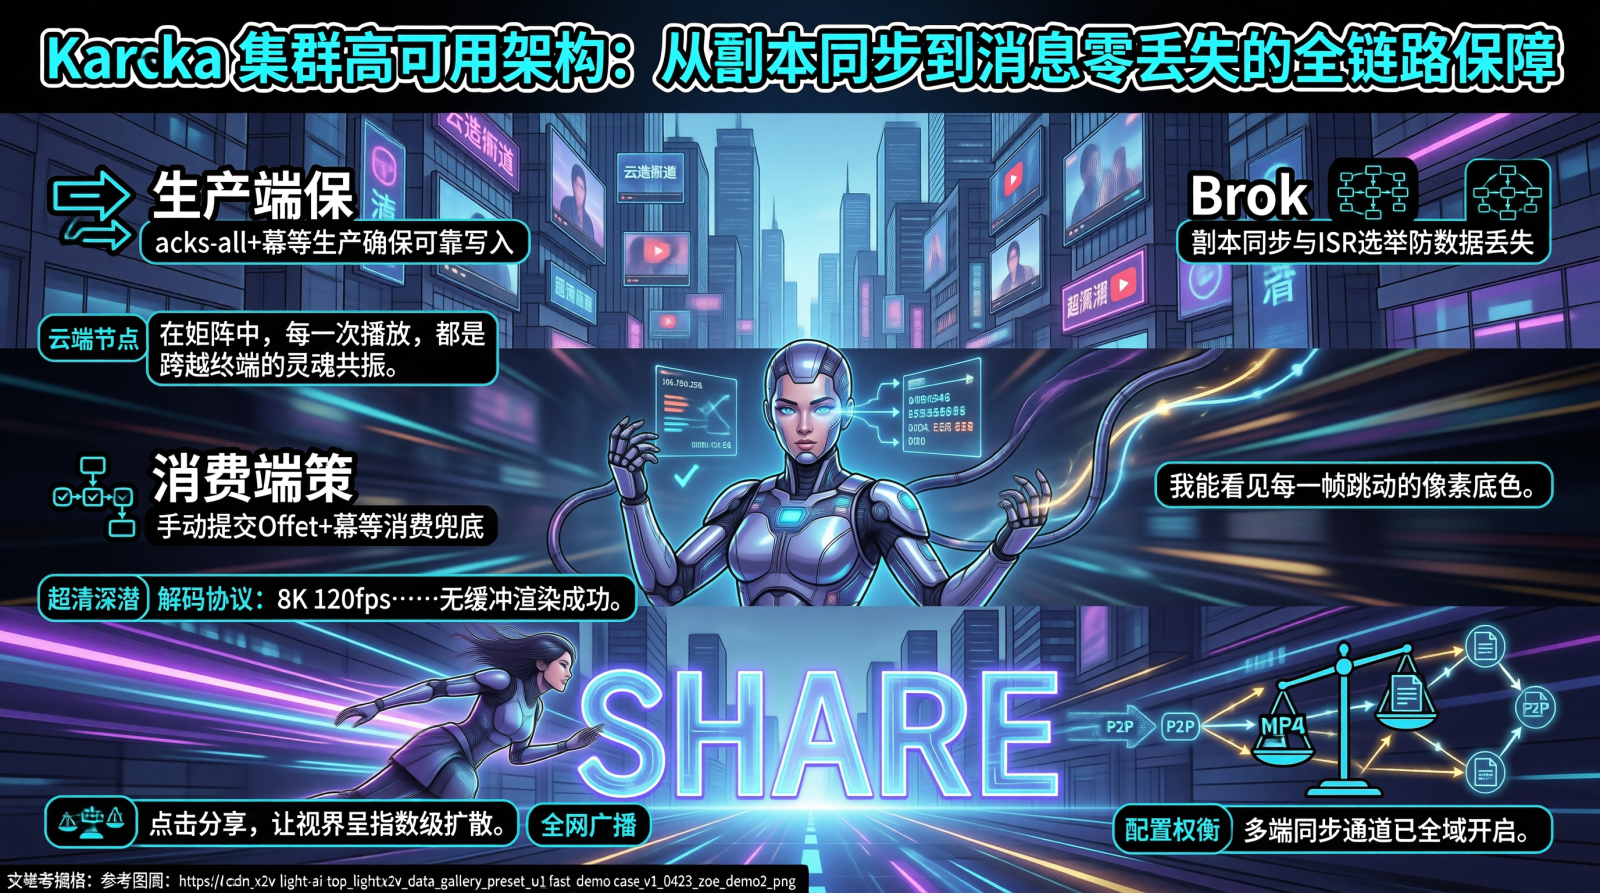
Kafka 集群高可用架构:从副本同步到消息零丢失的全链路保障 Kafka 消息零丢失需要三端协同保障:生产端使用acks=all+ 幂等生产确保消息可靠写入;Broker 端通过副本机制和 ISR 选举确保已提交消息不丢失;消费端通过手动提交 Offset 和幂... 国内服务器 2个月前290
Python 消息队列选型:从 Redis Stream 到 Kafka 的工程决策框架 消息队列选型的核心思路是“需求驱动选型,而非技术驱动选型”。低吞吐任务队列选 Redis Stream,复杂路由场景选 RabbitMQ,高吞吐事件流选 Kafka——每种队列都有其最优的适用场景。落... 国内服务器 2个月前330
RAG 架构实战:个人生活知识库的构建与检索优化 构建个人生活知识库的 RAG 系统,关键在于三个工程决策:第一,分块策略必须按文档类型差异化配置,而非一刀切;第二,检索阶段用宽召回+元数据重排替代硬过滤,避免跨类别知识被误杀;第三,上下文窗口的 T... 国内服务器 2个月前290
【大数据系统分析与设计】架构、应用系统结构化分析核心知识点 本文系统介绍了大数据系统架构与应用系统结构化分析的核心知识点。在架构部分,重点阐述了分布式文件系统(GFS/HDFS)、批处理框架(MapReduce/Spark)、流处理框架(Storm/Spark... 国内服务器 2个月前340
解读大数据领域Hadoop的分布式文件系统HDFS 随着互联网和物联网的发展,企业面临EB级规模的海量数据存储需求,传统集中式文件系统在扩展性、容错性和吞吐量上的瓶颈日益凸显。HDFS(Hadoop Distributed File System)作为... 国内服务器 2个月前360
Python 消息队列选型:Redis Streams 与 RabbitMQ 消息队列的核心价值在于解耦和削峰,选型的关键维度是投递语义和消费模型。Redis Streams 轻量快速,适合已有 Redis 基础设施且消息量中等的场景;RabbitMQ 功能完备,适合需要复杂路... 国内服务器 2个月前400