【大数据处理与分析】Hadoop在探讨:04 Hadoop生态系统中具有代表性的功能组件 Pig简化批处理编程;Tez优化DAG作业提升效率;Kafka作为高吞吐消息枢纽,连接Hadoop与多种专用系统,实现数据高效交换。三者分别解决开发效率、计算性能和数据流转问题。 国内服务器 4个月前470
HBase与Spark集成:大数据处理的黄金组合 随着企业数据量的指数级增长,单一技术已难以满足“实时存储+复杂计算”的双重需求:HBase擅长处理海量数据的随机读写与实时访问,但计算能力有限;Spark则以内存计算为核心,支持批处理、流处理、机器学... 国内服务器 4个月前450
大数据领域存算分离:架构解析与应用实践 随着企业数据量从TB级向EB级跃迁(例如某电商大促单日产生500TB日志),传统“存储与计算紧耦合”的架构(如Hadoop早期的HDFS+MapReduce)暴露出扩展性差、资源利用率低、成本高等问题... 国内服务器 4个月前400
如何选择最适合你的异步运行时:rust-rdkafka与smol、async-std集成实战指南 [特殊字符] rust-rdkafka 是一个基于librdkafka的完全异步、基于futures的Kafka客户端库,专为Rust语言设计。这个强大的库不仅支持默认的Tokio运行时,还提供了灵活的异步运行时集... 国内服务器 4个月前430
计算机毕业设计源码:双协同过滤商品推荐系统 Django 可视化 Bootstrap 人工智能 大数据 数据分析 推荐系统 agent 大模型 数据挖掘 deepseek(建议收藏)✅ 摘要 本项目开发了一个基于协同过滤算法的商品推荐系统,采用Python+Django技术栈构建。系统实现了基于用户和物品的双重协同过滤推荐算法,通过计算用户偏好相似度和商品关联度实现个性化推荐。主要功... 国内服务器 4个月前420
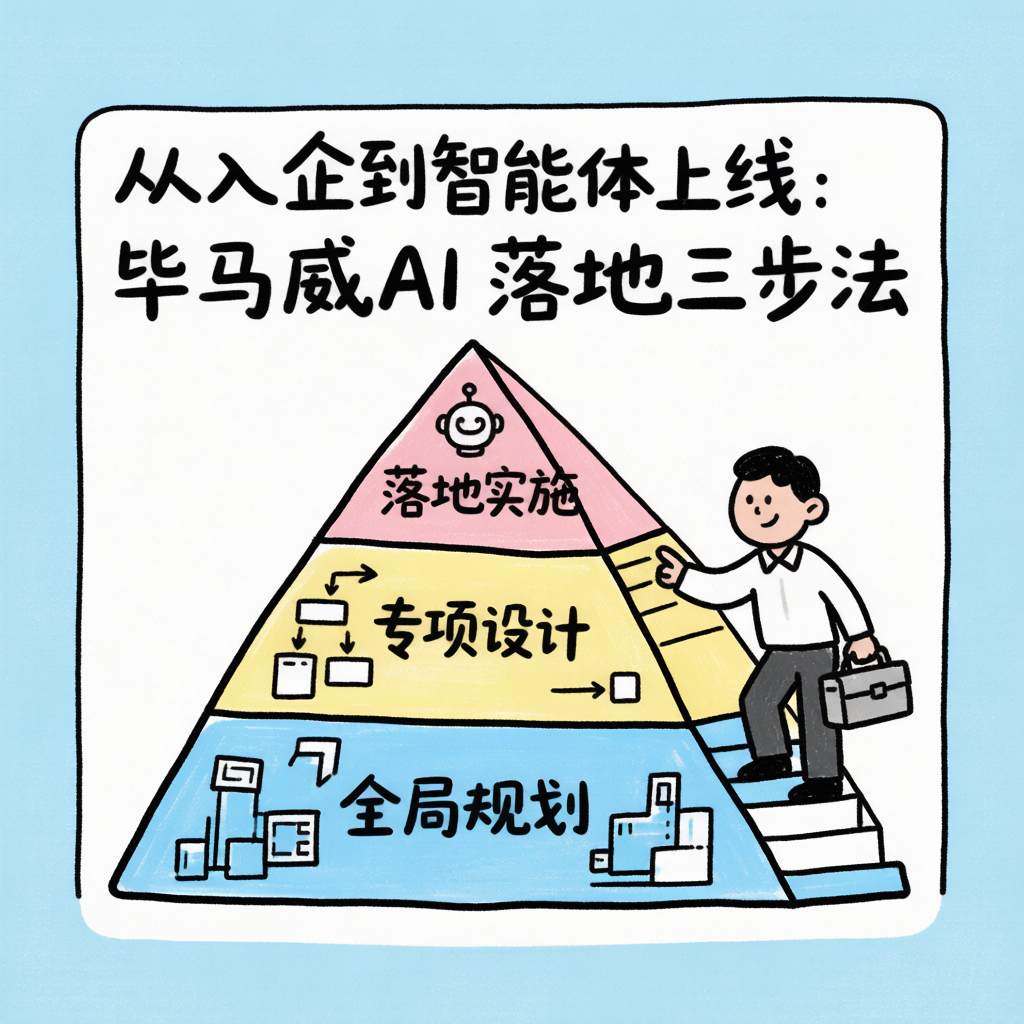
毕马威《2026全球技术报告》披露:AI 落地的三步法与 FDE 双轮驱动 AI 落地最难的部分,从来不是模型本身。难的是场景定义——能不能把"我们要用 AI"拆成一张张场景定义卡片;难的是流程再造——能不能根据风险等级为每个节点设计最合适的人机协同模式... 国内服务器 4个月前740
3.3 国内数据治理发展:从国家大数据战略到 DCMM 评估,中国数据治理的黄金十年 中国数据治理的发展,走了一条自上而下、政策引领、评估驱动的高效之路。从 2015 年大数据战略启航,到 2020 年数据跻身生产要素,再到《数据二十条》奠定制度基石,最后通过 DCMM 让治理可量化... 国内服务器 4个月前470
Flume与流处理框架集成实践:从Storm到Flink的架构演进 采集层(Flume):多源接入、事务保证、可靠传输缓冲层(Kafka):削峰填谷、多订阅、持久化保障处理层(Storm/Flink):实时计算、状态管理、复杂事件处理架构演进趋势Storm → Fli... 国内服务器 4个月前390
Kubernetes Job 跑批推理:完成任务比常驻服务更重要 Kubernetes Job 适合离线 AI 跑批推理。关键是区分在线离线任务,设计幂等输入、合理资源申请、并发控制、结果存储和失败样本管理。不是所有推理都要常驻服务。对跑批任务来说,稳定完成、可恢复... 国内服务器 4个月前490