【大数据系统分析与设计】架构、应用系统结构化分析核心知识点 本文系统介绍了大数据系统架构与应用系统结构化分析的核心知识点。在架构部分,重点阐述了分布式文件系统(GFS/HDFS)、批处理框架(MapReduce/Spark)、流处理框架(Storm/Spark... 国内服务器 4个月前500
解读大数据领域Hadoop的分布式文件系统HDFS 随着互联网和物联网的发展,企业面临EB级规模的海量数据存储需求,传统集中式文件系统在扩展性、容错性和吞吐量上的瓶颈日益凸显。HDFS(Hadoop Distributed File System)作为... 国内服务器 4个月前530
Python 消息队列选型:Redis Streams 与 RabbitMQ 消息队列的核心价值在于解耦和削峰,选型的关键维度是投递语义和消费模型。Redis Streams 轻量快速,适合已有 Redis 基础设施且消息量中等的场景;RabbitMQ 功能完备,适合需要复杂路... 国内服务器 4个月前590
3大Kafka消费性能瓶颈突破技巧:告别频繁Rebalance的终极指南 你是否遇到过Kafka消费者频繁触发rebalance、消息积压持续增长,或者监控面板上消费延迟曲线不断飙升?这些问题背后往往隐藏着批量消费配置不当的核心症结。本文将从问题诊断到实战验证,带你系统化突... 国内服务器 4个月前400
Kafka 消息可靠性投递——从生产者到消费者的全链路保障 Kafka 的全链路可靠性需要三个层面的协同配置。acks=all+ 幂等性 + 重试策略 + 本地死信兜底。消费者层:手动位移提交 + 业务幂等 + 异常分类处理。运维层:Broker+ 端到端监控... 国内服务器 4个月前460
Kafka Python 客户端实战:消费位移管理的可靠性陷阱与 Exactly-Once 语义实现 Kafka Python 客户端的可靠消费不是配置问题,而是架构问题。位移提交的时机、幂等性的实现、重平衡的处理,每一个环节都需要在吞吐量与一致性之间做出明确的权衡。位移提交策略得跟业务需求匹配。先处... 国内服务器 4个月前360
从日志到 HBase:用 Flume、Kafka、Flink 串起一条实时数据链路 从日志到 HBase 的这条实时链路,是大数据入门的一个经典实验。把 Flume、Kafka、Flink 串起来跑通之后,再去看生产架构会清晰很多。如果你在搭建过程中遇到问题,或者有自己想尝试的链路组... 国内服务器 4个月前380
ArchivePasswordTestTool:智能压缩包密码找回工具终极指南 你是否曾经因为忘记压缩包密码而无法访问重要文件?ArchivePasswordTestTool正是为你解决这一困扰的专业工具。这款基于7zip引擎的开源软件能够自动化测试密码字典,帮你快速找回丢失的压... 国内服务器 4个月前440
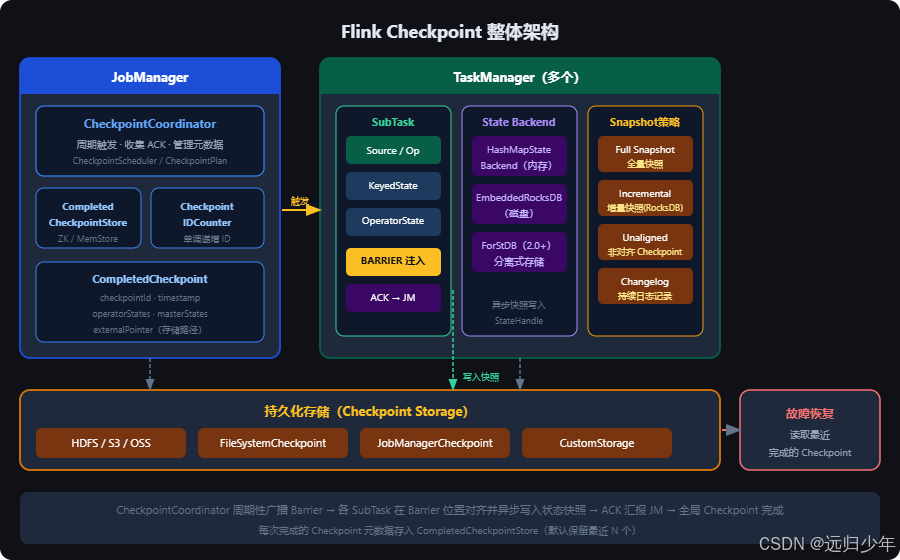
Apache Flink Checkpoint 与 Chandy-Lamport 算法深度解析 本文系统梳理了Flink Checkpoint机制的核心原理与实现。Checkpoint作为Flink容错的核心组件,通过周期性全局快照实现Exactly-Once语义。文章详细解析了Checkpoi... 国内服务器 4个月前460
flink接入spring体系 注意的是SpringApplicationContext要保证进程单例, 不要在算子的open()方法中创建SpringApplicationContext, 否则在并行执行算子时会导致重复创建Spr... 国内服务器 4个月前430