数据建模师必看:大数据环境下的建模技巧 随着企业数据规模从TB级迈向PB级,传统数据建模方法在数据吞吐量、处理延迟、模型迭代效率上遭遇瓶颈。本文聚焦大数据环境下的建模技术升级,覆盖从数据采集层到模型部署层的全流程优化策略,重点解析分布式计算... 国内服务器 3个月前330
消息驱动Spring Cloud Stream与RabbitMQ整合 本文介绍了消息队列的应用场景和RabbitMQ的使用方法。通过用户注册发短信、双11订单处理和订单状态变更三个典型场景,展示了消息队列异步处理的优势。文章对比了主流消息队列产品的特点,推荐使用Rabb... 国内服务器 3个月前330
libarchive源码解析:从数据流处理到格式识别的内部机制 libarchive是一个功能强大的多格式归档与压缩库,为开发者提供了统一的API来处理各种归档文件格式。无论您需要读取tar、zip、7z还是其他格式的归档文件,libarchive都能提供高效的数... 国内服务器 3个月前210
大数据国潮男装微博评论数据分析系统的设计与实现 爬虫可视化大数据_ 2、同时增加文字触发提醒,设置提醒语,有相同字段的数据,会触发弹框提醒,例如设置状态提醒:特急/加急/一般 增加自定义提醒语(如:库存不足,请补货)对于本系统,我们提供全方位的支持,包括修改时间和标题... 国内服务器 3个月前380
大数据 / 数据仓库常见面试题及答案汇总(2026 最新版) 2026年大数据行业持续繁荣,市场规模突破3万亿元,人才缺口扩大,复合型高级人才年薪50万以上。面试难度提升,聚焦实时计算(Flink)、湖仓一体(Delta Lake等)、AI数据工程(大模型数据管... 国内服务器 3个月前350
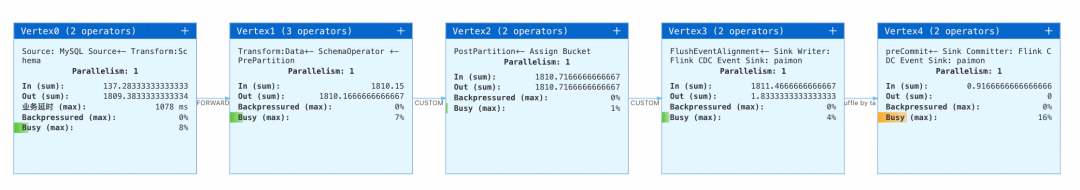
AI时代下的万表入湖:Flink CDC + Paimon 企业级入湖实践 阿里云实时计算 Flink 提供了 AI 助手能力:在控制台右下角点击悬浮按钮,即可打开 AI 助手,用自然语言描述你的同步需求——例如"请生成一个Flink CDC YAML 作业,我需要... 国内服务器 3个月前350
Kafka-King:三步搞定Kafka管理难题的GUI神器 你是否曾经为了查看某个Topic的消费进度而在命令行中反复敲击kafka-consumer-groups命令?是否因为复杂的SASL认证配置而头痛不已?在Kafka集群管理这条路上,我们总是需要一款能... 国内服务器 3个月前400
剖析大数据领域Eureka的工作原理 本文旨在深入解析Eureka服务发现组件的工作原理,特别关注其在大数据环境中的应用。我们将全面覆盖Eureka的核心概念、架构设计、实现机制以及实际应用,帮助开发者和架构师更好地理解和运用这一关键技术... 国内服务器 3个月前300
kafka测试思路 本文系统介绍了Kafka中间件的测试方法与实践指南。主要内容包括:Kafka核心概念解析(Broker、Topic、Partition等)、高吞吐实现原理;详细测试方案涵盖功能测试(收发验证、高可用测... 国内服务器 3个月前370
30分钟用RabbitMQ搭建微服务通信原型 整个过程最让我惊喜的是,平台已经预装了RabbitMQ等常用中间件,省去了大量搭建时间。下面分享我如何在30分钟内搭建一个可运行的微服务通信原型,这个案例包含了订单服务和库存服务的基本交互。当新订单生... 国内服务器 3个月前350