剖析大数据领域Eureka的工作原理 本文旨在深入解析Eureka服务发现组件的工作原理,特别关注其在大数据环境中的应用。我们将全面覆盖Eureka的核心概念、架构设计、实现机制以及实际应用,帮助开发者和架构师更好地理解和运用这一关键技术... 国内服务器 4个月前410
kafka测试思路 本文系统介绍了Kafka中间件的测试方法与实践指南。主要内容包括:Kafka核心概念解析(Broker、Topic、Partition等)、高吞吐实现原理;详细测试方案涵盖功能测试(收发验证、高可用测... 国内服务器 4个月前500
30分钟用RabbitMQ搭建微服务通信原型 整个过程最让我惊喜的是,平台已经预装了RabbitMQ等常用中间件,省去了大量搭建时间。下面分享我如何在30分钟内搭建一个可运行的微服务通信原型,这个案例包含了订单服务和库存服务的基本交互。当新订单生... 国内服务器 4个月前530
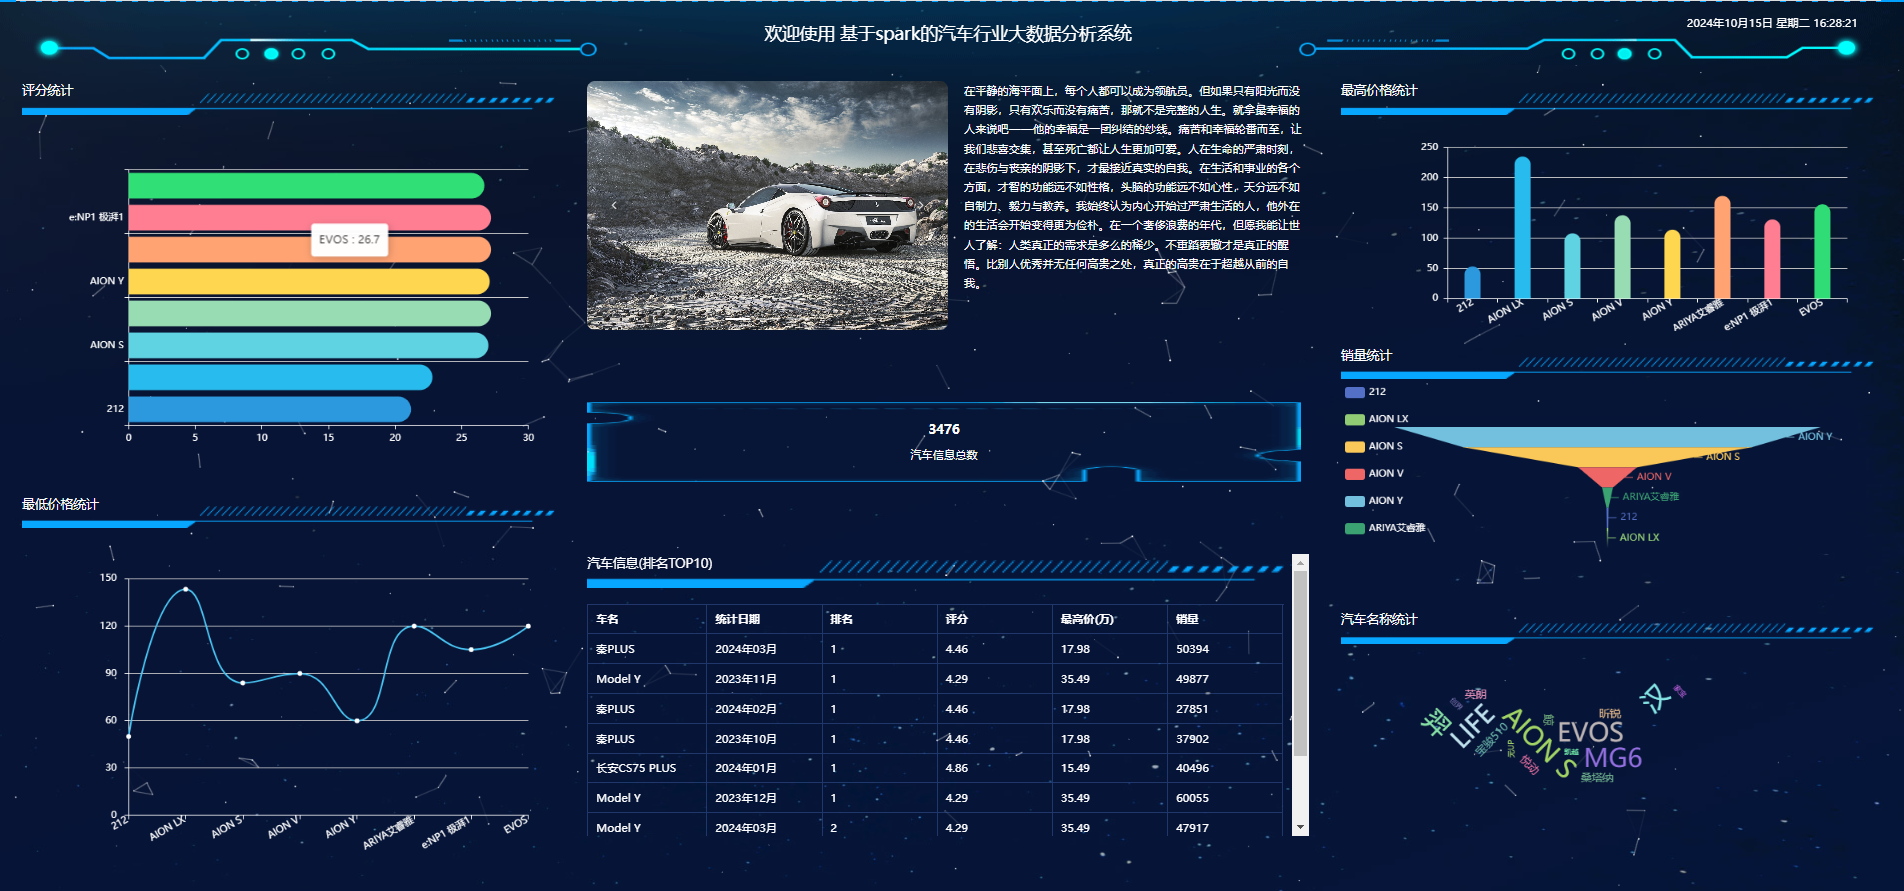
基于网络爬虫+Spark+Hadoop等大数据和SpringBoot技术实现的的汽车行业大数据分析与可视化平台系统(源码+论文+PPT+部署文档教程等) 汽车行业大数据分析系统是一款集成了数据采集、处理、分析和可视化的高级平台。该系统能够通过高效的数据仓库技术进行存储和管理。利用先进的分析算法,系统可以对车辆性能进行深入分析,该系统还具备强大的可视化功... 国内服务器 4个月前560
Kafka专辑: 日志存储模型 1. **顺序写(Sequential Write)**:将磁盘利用率最大化。2. **页缓存(Page Cache)**:依赖 OS 缓存,写入即内存,读取优先命中内存。3. **零拷贝(Zero... 国内服务器 4个月前510
Clawdbot消息队列优化:Kafka高吞吐企业微信消息处理 本文介绍了如何在星图GPU平台上自动化部署Clawdbot 汉化版 增加企业微信入口镜像,实现高吞吐、低延迟的企业微信消息处理。通过Kafka消息队列优化,该镜像可稳定支撑中大型企业级群聊与私聊消息的... 国内服务器 4个月前480
Kafka 从入门到精通 — 完整学习笔记 本文为Apache Kafka 4.3.0的完整学习笔记,基于华为云4节点集群环境(Ubuntu 24.04)搭建KRaft模式集群。内容涵盖Kafka从基础到高级的15个章节,包括核心概念、安装配置... 国内服务器 4个月前430
Apache Flink SQL连接器版本管理终极指南:从架构设计到生产实践 Apache Flink作为流处理领域的领军框架,其SQL连接器的版本管理直接影响数据集成的稳定性与性能。本文将系统讲解Flink SQL连接器的版本选择策略、架构设计原理及生产环境最佳实践,帮助开发... 国内服务器 4个月前450
大数据领域数据服务的成本控制与效益提升 随着企业数据规模呈指数级增长,大数据服务的运营成本已成为企业IT预算的重要组成部分。大数据基础设施的成本控制数据处理流程的效率提升资源利用率的优化服务质量与成本的平衡研究范围涵盖从基础设施选型到数据处... 国内服务器 4个月前350
Zookeeper在大数据机器学习平台中的应用 在大数据机器学习平台的构建和运行过程中,面临着诸多挑战,如分布式系统的协调管理、资源的动态分配、任务的调度等。Zookeeper作为一个高性能的分布式协调服务,能够为大数据机器学习平台提供稳定可靠的协... 国内服务器 4个月前440