深度剖析大数据领域数据生命周期的存储策略 数据生命周期存储策略的核心逻辑是**“以数据为中心”——根据数据在生命周期不同阶段的特征(访问频率、性能需求)**,选择合适的存储系统,实现“成本最优”与“性能满足”的平衡。采集阶段:用分布式消息队列... 国内服务器 7个月前650
大数据新视界 — Hive 事务管理的应用与限制(2 – 16 – 8) 本文深入探究 Hive 事务管理,详述应用场景、优势,剖析限制并提出应对策略,含代码示例,助力提升 Hive 事务处理能力。 国内服务器 7个月前650
分布式锁超时处理全攻略(含Redis/ZooKeeper对比实践) 掌握分布式锁的超时处理关键方法,避免死锁与资源争用。对比Redis与ZooKeeper实现方案,涵盖适用场景、自动续期与容错机制,提升系统可靠性,值得收藏。 国内服务器 7个月前650
从时序迷宫到稳定通信:深入解析SPI的CPOL与CPHA模式选择策略 本文深入解析SPI通信中CPOL与CPHA的四种模式选择策略,帮助工程师避免时序配置错误导致的通信失败。通过详解时钟极性和相位的时序行为,结合STM32实战配置示例,提供从设备适配、信号完整性到多设备... 国内服务器 7个月前650
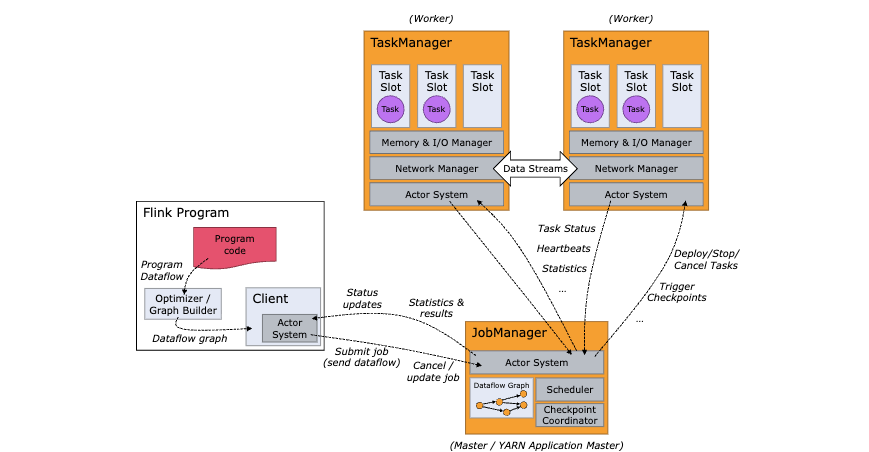
flink架构和关键组件 本质:Flink 算子在处理流数据时,需要保存的中间计算结果或历史信息,是算子的 “内存”。例如:窗口聚合中累计的订单数、用户会话的状态、CDC 同步中的数据版本号等。作用:支撑有状态的计算,让流处理... 国内服务器 7个月前650
用Redis实现分布式锁和用Zookeeper实现有什么区别? 想象一下,我们的软件系统就像一座城市。早期的单体应用如同一个小型村庄,所有功能都集中在一个简单的建筑中,村民(用户)不多,生活(系统运行)井然有序。但随着村庄发展为繁华都市(用户规模增长),单一建筑已... 国内服务器 7个月前650
计算机毕业设计Python+PySpark+Hadoop图书推荐系统 图书可视化大屏 大数据毕业设计(源码+LW文档+PPT+讲解) 本文介绍了一个基于Python+PySpark+Hadoop的图书推荐系统开发项目。系统旨在解决互联网图书资源过载问题,通过协同过滤和内容过滤算法实现个性化推荐。项目采用Hadoop存储数据,PySp... 国内服务器 7个月前650
ZAB 协议深度解析:ZooKeeper 分布式一致性的核心 ZooKeeper核心共识协议ZAB(ZooKeeper Atomic Broadcast)详解 摘要: ZAB协议是Apache ZooKeeper实现强一致性的核心机制,通过两种工作模式保证数据安... 国内服务器 7个月前650
基于NoSQL数据库的大数据诊断性分析方案 你是否遇到过这样的场景?用MongoDB存储的电商订单系统,突然查询延迟从50ms飙升到500ms,日志里却只有“slow query”警告;Cassandra集群的写吞吐量骤降,监控面板显示“pen... 国内服务器 7个月前650
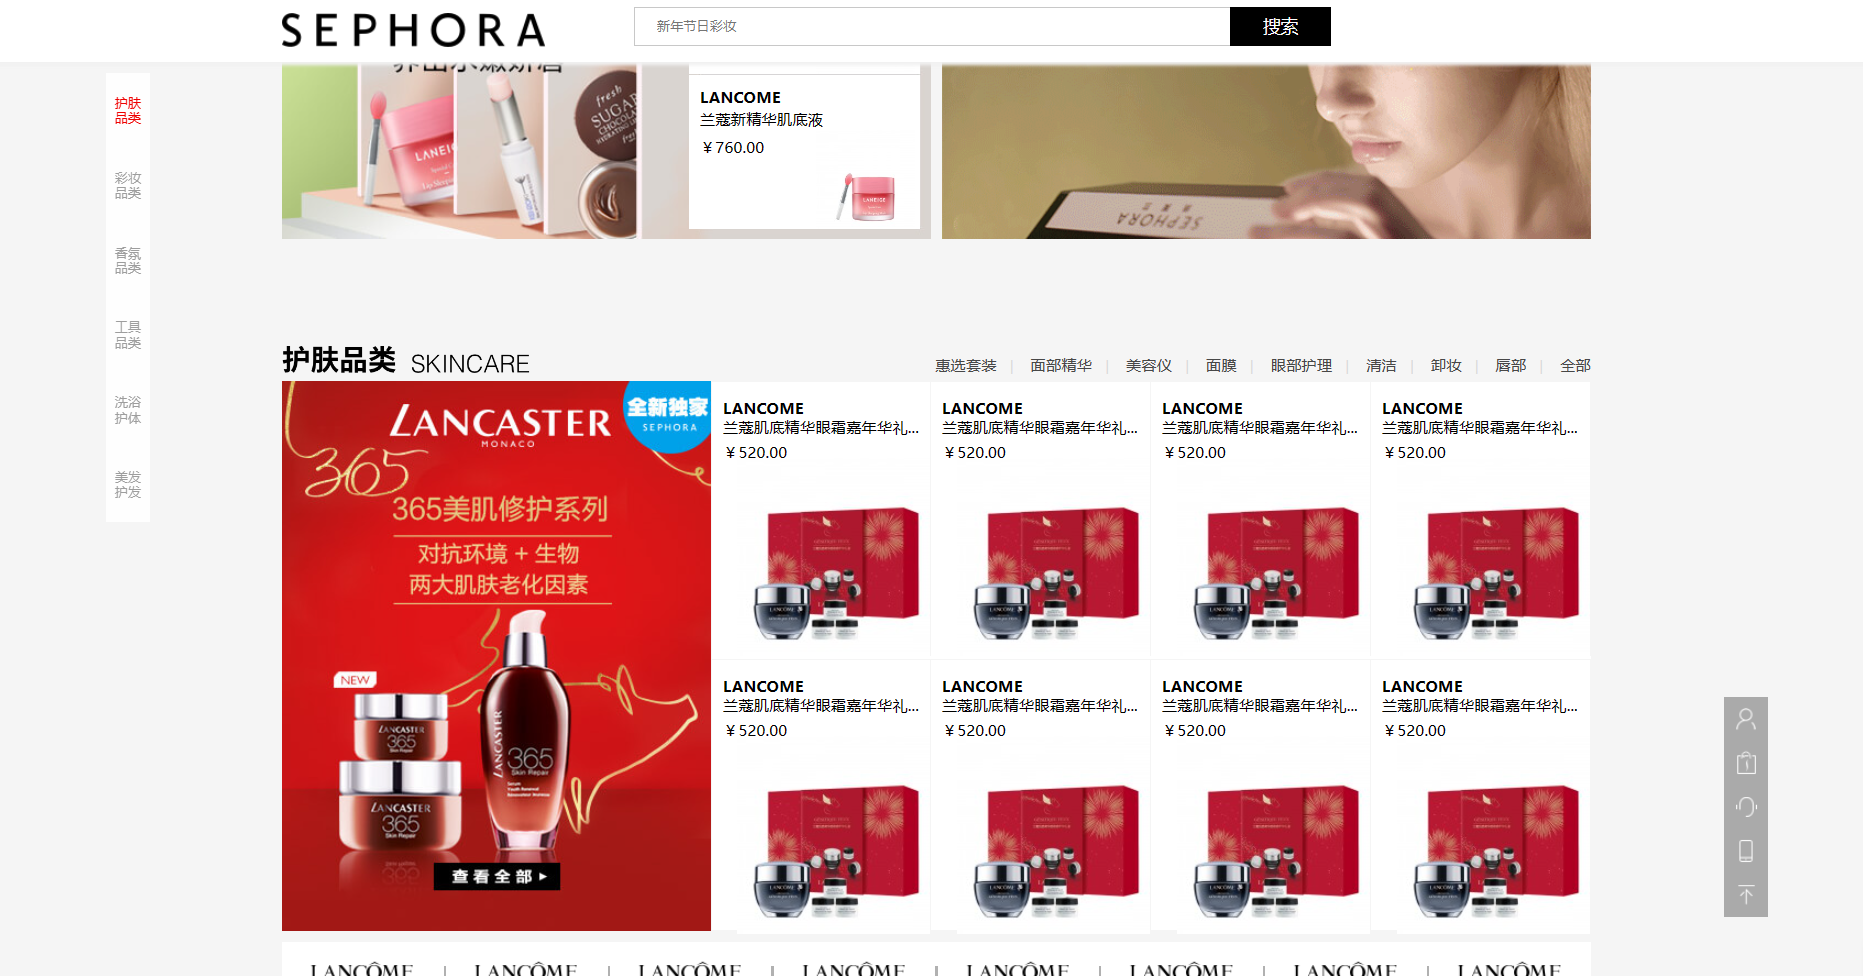
大学生HTML期末大作业——HTML+CSS+JavaScript购物商城(丝芙兰) HTML+CSS+JS【购物商城】网页设计期末课程大作业 web前端开发技术 web课程设计 网页规划与设计 国内服务器 7个月前650