从零到精通 Hadoop 的系统学习文档 本文系统介绍了Hadoop生态系统的学习路径与核心技术,包含三个阶段:从伪分布式环境搭建到集群管理与性能优化。重点讲解了HDFS、YARN、MapReduce三大核心组件的工作原理与配置方法,详细说明... 国内服务器 7个月前710
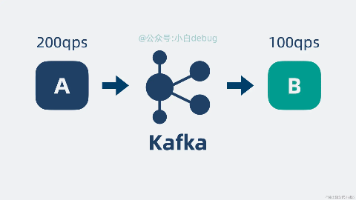
kafka高可用和负载均衡一次搞定 bin/kafka-topics.sh --describe --topic test_cluster --bootstrap-server 192.168.200.202:9092 # 查看 Top... 国内服务器 7个月前520
【Kafka进阶篇】拆解Kafka核心:LEO、HW与Leader Epoch的关联与应用 摘要: Kafka早期仅依赖高水位线(HW)定义消息可见性,但存在数据丢失和不一致的风险,尤其在故障切换后原Leader重新加入时,HW无法识别有效消息导致盲目截断。为此,Kafka 0.11引入Le... 国内服务器 7个月前630
卡夫卡(Kafka)从入门到实践:超详细学习指南 卡夫卡是由 Apache 软件基金会开发的分布式流处理平台,最初由 LinkedIn 公司设计,用于解决大规模日志收集与传输问题。它的核心定位是 “高吞吐量的分布式发布 - 订阅消息系统”,具有高吞吐... 国内服务器 7个月前660
– 互联网产品 + 大数据产品 = 大数据平台 从今天开始,我们进入专栏的“大数据平台与系统集成”模块。前面我讲了各种大数据技术的原理与架构,大数据计算通过将可执行的代码分发到大规模的服务器集群上进行分布式计算,以处理大规模的数据,即所谓的移动计算... 国内服务器 7个月前620
大数据 Cassandra 与其他数据库的对比分析 在当今大数据时代,数据量呈爆炸式增长,不同类型的数据库应运而生以满足各种数据存储和处理的需求。本文的目的就是对比分析 Cassandra 数据库与其他常见数据库的优缺点,范围涵盖关系型数据库如 MyS... 国内服务器 7个月前720
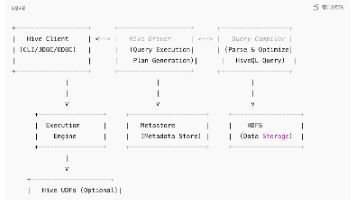
大数据新视界 — Hive 数据仓库:架构深度剖析与核心组件详解(上)(1 / 30) 本文聚焦 Hive 数据仓库,开篇回顾 Impala 成果后深入阐述 Hive 起源发展、与传统数据库差异,深度剖析其架构核心组件(元数据存储与运行时引擎)及多种数据存储格式(Parquet、ORC... 国内服务器 7个月前740
Hadoop 架构 Hadoop是由Apache开发的分布式系统基础架构,主要用于解决海量数据的存储和分析问题。它具有高可靠性(多数据副本)、高扩展性(支持千级节点)、高效性(并行处理)和高容错性(自动任务重分配)等优势... 国内服务器 7个月前720
基于大数据爬虫+Hadoop+电脑商品数据爬取与可视化平台设计与开发(源码+精品论文+答辩PPT等资料) 在数字经济与电子商务深度渗透的当下,电脑及配件市场呈现出产品迭代加速、价格波动频繁、配置组合复杂的显著特征。从中央处理器到显卡,从轻薄本到游戏本,从品牌整机到DIY配件,消费者面对的是数以万计的商品选... 国内服务器 7个月前530
计算机大数据毕设实战-基于Hadoop+springboot的宁波旅游推荐周边商城实现与设计个性化游玩推荐 – 周边商品选购 【完整源码+LW+部署说明+演示视频,全bao一条龙等】 主要内容:免费开题报告、任务书、全bao定制+中期检查PPT、代码编写、🚢文编写和辅导、🚢文降重、长期答辩答疑辅导、一对一专业代码讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。 国内服务器 7个月前770