数据仓库高效运维:ETL调度与任务管理实战落地指南 按照预设时间、依赖关系、优先级,自动驱动数据抽取、转换、加载任务有序、高效、可靠执行的过程。分布式架构保证高可用、高并发分层依赖保证任务有序执行增量同步提升运行效率并发控制保证系统稳定。 国内服务器 3个月前380
从结构化到多模态:Apache Flink,多模态数据处理的流式底座 过去很长一段时间里,数据处理系统主要围绕结构化记录展开:订单、日志、点击、交易、指标、维表、事实表。数据被抽象成一行行 schema 清晰的记录,核心任务是清洗、关联、聚合、统计。这类链路支撑了搜索... 国内服务器 3个月前480
从数据管道到推理服务:链路中每个环节的缓存都值得审视 数据管道:文档解析结果是否有缓存?分块结果是否有缓存?Embedding 向量是否有缓存?分块策略和 Embedding 模型版本是否已纳入缓存 Key?推理请求入口:请求解析是否需要缓存?HTTP ... 国内服务器 3个月前320
SpringBoot 地铁 ISCS 实战第十二篇:上位智能采集器设计|OPC UA 采集层 + Kafka 消息队列统一转发落地实战 本文提出了一种基于OPC UA和Kafka的地铁综合监控系统上位智能采集器解决方案,实现了采集与业务完全解耦的工业级数据采集架构。该方案通过四层结构:现场设备层、统一采集总线层、上位智能采集器层和业务... 国内服务器 3个月前500
掌握大数据领域数据清洗,优化数据管理流程 随着企业数据规模以年均40%的速度增长(Gartner, 2023),数据噪声问题愈发凸显。据IDC统计,企业平均30%的数据分析时间耗费在数据清洗环节,低效的清洗流程导致数据价值释放延迟。本文聚焦大... 国内服务器 3个月前400
一文搞懂hadoop的HDFS Hadoop是由Apache基金会所开发的分布式系统基础架构,旨在解决海量数据存储和计算分析问题。狭义上来说,Hadoop是指Apache Hadoop开源框架,包含以下三种核心组件:广义上来说,Ha... 国内服务器 3个月前370
Spark + 数据湖:构建实时分析管道的5个关键技巧 随着企业对实时数据洞察的需求激增,基于数据湖的实时分析管道成为数据架构的核心组件。本文聚焦Apache Spark与数据湖的深度集成,系统讲解构建高可用、高性能实时管道的关键技术点,涵盖数据摄入、处理... 国内服务器 3个月前410
PyUSB数据传输完全指南:控制、批量、中断、等时四种传输模式 PyUSB是一款功能强大的Python库,为开发者提供了简单易用的USB设备访问接口。本文将详细介绍PyUSB支持的四种USB数据传输模式——控制传输、批量传输、中断传输和等时传输,帮助你轻松掌握各类... 国内服务器 3个月前580
Hadoop 核心技术深度解析:从架构原理到实战应用 本文深度解析Hadoop 3.x核心技术体系,涵盖分布式存储(HDFS)、计算框架(MapReduce)和资源调度(YARN)三大核心组件。重点探讨了3.x版本的关键升级:HDFS支持多NameNod... 国内服务器 3个月前370
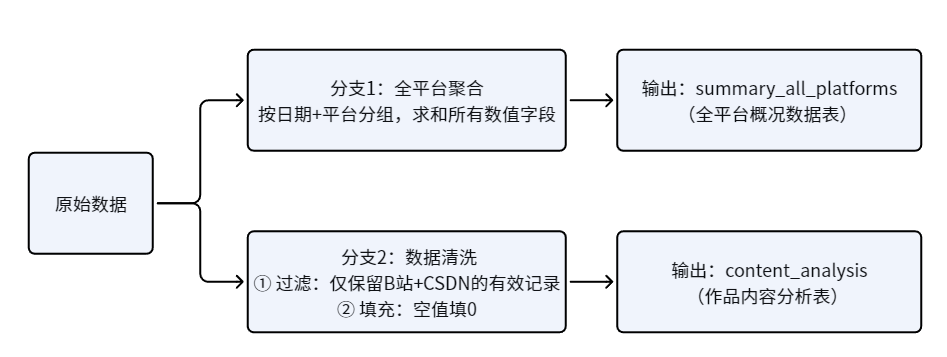
【大数据实验】基于助睿ETL实现自媒体运营数据清洗与预处理 摘要: 本次实验利用助睿ETL零代码工具对多平台自媒体互动数据进行清洗与预处理。通过双分支处理设计,分别输出全平台汇总统计表(保留原始数据)和重点平台(B站、CSDN)精细化明细表(剔除无效记录、填充... 国内服务器 3个月前370