【大数据系统分析与设计】架构、应用系统结构化分析核心知识点 本文系统介绍了大数据系统架构与应用系统结构化分析的核心知识点。在架构部分,重点阐述了分布式文件系统(GFS/HDFS)、批处理框架(MapReduce/Spark)、流处理框架(Storm/Spark... 国内服务器 2个月前350
Python 消息队列选型:Redis Streams 与 RabbitMQ 消息队列的核心价值在于解耦和削峰,选型的关键维度是投递语义和消费模型。Redis Streams 轻量快速,适合已有 Redis 基础设施且消息量中等的场景;RabbitMQ 功能完备,适合需要复杂路... 国内服务器 2个月前400
Kafka 消息可靠性投递——从生产者到消费者的全链路保障 Kafka 的全链路可靠性需要三个层面的协同配置。acks=all+ 幂等性 + 重试策略 + 本地死信兜底。消费者层:手动位移提交 + 业务幂等 + 异常分类处理。运维层:Broker+ 端到端监控... 国内服务器 2个月前330
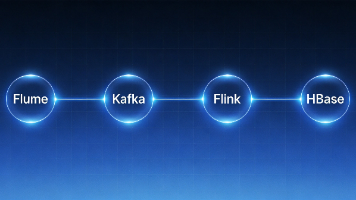
从日志到 HBase:用 Flume、Kafka、Flink 串起一条实时数据链路 从日志到 HBase 的这条实时链路,是大数据入门的一个经典实验。把 Flume、Kafka、Flink 串起来跑通之后,再去看生产架构会清晰很多。如果你在搭建过程中遇到问题,或者有自己想尝试的链路组... 国内服务器 2个月前270
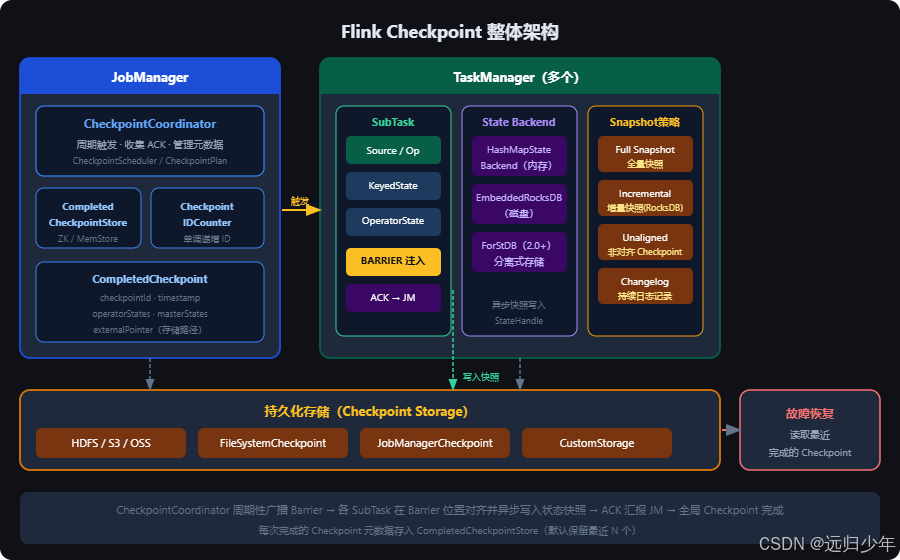
Apache Flink Checkpoint 与 Chandy-Lamport 算法深度解析 本文系统梳理了Flink Checkpoint机制的核心原理与实现。Checkpoint作为Flink容错的核心组件,通过周期性全局快照实现Exactly-Once语义。文章详细解析了Checkpoi... 国内服务器 2个月前310
【黑产大数据】2025年全球电商业务欺诈风险研究报告 2025年,威胁猎人监测全球电商风险线索达1500万条、黑灰产相关帐号160万个,风险高度集中于欧洲、中国与美国,黑灰产针对全球电商平台的攻击方式,均深度贴合平台业务流程,形成覆盖账号、货源、履约与售... 国内服务器 2个月前300
Spark Datafusion Comet 向量化Rust Native–执行Datafusion计划 摘要 Apache Datafusion Comet是苹果开源的Spark向量化加速项目,采用Spark插件化+Protobuf+Arrow+DataFusion架构。项目通过SparkPlugin实... 国内服务器 2个月前330
Kafka 消费幂等:重复消息不可怕,重复副作用才可怕 Kafka 消费端要接受重复消息存在,重点是避免重复副作用。稳定幂等键、本地事务、外部调用幂等和失败分类,是消费系统可靠性的基础。重复消息不可怕,不可控的业务副作用才可怕。 国内服务器 2个月前340
消息队列选型深度对比:Kafka vs Pulsar vs NATS的场景决策指南 流式ETL和大数据处理首选Kafka:生态成熟,Connector丰富,不可变日志模型天然适合数据管道微服务异步通信首选NATS:延迟亚毫秒级,部署极简,天然支持请求-响应模式多租户SaaS首选Pul... 国内服务器 2个月前280