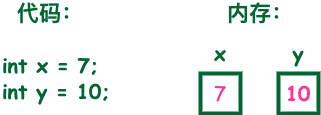时序数据库选型指南:基于大数据视角的IoTDB应用优势分析详解! 时序数据库选型的关键在于匹配业务需求与数据特征。本文系统分析了选型核心维度:数据规模与写入性能(百万级/秒)、查询需求(范围/聚合/告警)、存储优化(压缩/分层)、扩展性与高可用。重点推荐IoTDB在... 国内服务器 8个月前730
python基于Hadoop的网购平台用户购买力差异分析及研究 本文介绍了基于Python与Hadoop的网购平台用户购买力差异分析系统。该项目通过Hadoop生态处理海量用户数据,运用Python进行数据分析和可视化,采用K-Means聚类算法将用户划分为高、中... 国内服务器 8个月前730
RabbitMQ直接查看队列中消息的内容 方法是否可看内容是否影响队列用途❌❌查看队列状态✅✅(会消费)小量调试临时消费者脚本✅❌(不 ack)安全调试镜像队列观察✅❌生产调试插件工具✅⚠️不推荐实验性。 国内服务器 8个月前730
Blue Archive自动脚本:从零开始掌握游戏自动化终极指南 你是否曾经因为重复的游戏任务而感到疲惫?每天需要手动完成资源收集、活动挑战、队伍管理,这些重复性操作不仅消耗时间,还容易让人产生厌倦感。现在,一款专门为《Blue Archive》(蔚蓝档案)设计的自... 国内服务器 8个月前730
基于Spark的大规模数据集成处理实战教程 在数字化时代,企业数据像“爆炸的烟花”——来源多(日志、数据库、IoT设备)、格式杂(CSV/JSON/关系表)、规模大(TB级甚至PB级)。传统工具(如Python脚本、Excel)处理这类数据时... 国内服务器 5个月前720
DGX-spark-GB10 120GB显存的机器,为什么部署Qwen3-14B生成速率才13tokens/s 摘要:Qwen3-14B Q8_0模型13t/s的速度属于正常范围,主要受限于DGXSpark的显存带宽(~273GB/s)。Dense架构大模型在推理阶段是内存带宽受限,而非算力受限。提升方案包括... 国内服务器 6个月前720
Flink SQL INSERT 语句单表写入、多表分流、分区覆盖与 StatementSet Flink SQL 中的 INSERT 语句用于将数据写入目标表,支持多种灵活用法。主要功能包括:1)通过 executeSql 立即提交单条 INSERT 作业,或使用 StatementSet 批... 国内服务器 6个月前720
Java 大视界 — Java 大数据在智能教育在线考试系统中的考试结果分析与教学反馈优化中的应用(420) 本文聚焦智能教育在线考试系统 “分析浅、反馈慢、个性化弱” 痛点,结合 Java 大数据技术(Spark/Flink/Elasticsearch),拆解多维考试结果分析、实时个性化反馈两大核心场景,附... 国内服务器 6个月前720
Java语言提供了八种基本类型fdz 变量就是申请内存来存储值。也就是说,当创建变量的时候,需要在内存中申请空间。内存管理系统根据变量的类型为变量分配存储空间,分配的空间只能用来储存该类型数据。因此,通过定义不同类型的变量,可以在内存中储... 国内服务器 6个月前720
二、Spark 开发环境搭建 IDEA + Maven 及 WordCount 案例实战 想在自己的电脑上写Spark程序,第一步就是搭好开发环境。这次我会手把手带你在IDEA里完成所有设置:从创建Maven项目、配置好与Spark版本匹配的Scala,到在pom.xml里添加核心依赖。它... 国内服务器 6个月前720