Apache Flink 在 Kubernetes 上的高效部署与优化实践 本文档提供Kubernetes环境下部署Apache Flink作业的系统化实践方案。在镜像构建方面,建议采用多阶段构建合并RUN指令,分离基础镜像与作业镜像;资源调度上,通过节点标签划分固定与弹性节... 国内服务器 7个月前840
CMake报错symbol lookup error?手把手教你修复archive_write_add_filter_zstd缺失问题 本文详细解析了CMake构建过程中遇到的`symbol lookup error: undefined symbol: archive_write_add_filter_zstd`报错问题,提供了从基... 国内服务器 7个月前840
深入解析 systemd 服务启动失败问题:以 Kafka 服务为例 如何分析systemd服务失败日志。排查 Kafka 服务崩溃的常见原因(如配置错误、资源不足)。优化systemd单元文件和启动脚本。预防类似问题的措施(如日志管理、资源限制)。systemd服务管... 国内服务器 7个月前840
计算机毕业设计Hadoop+Spark+Hive招聘推荐系统 招聘大数据分析 大数据毕业设计(源码+文档+PPT+ 讲解) 本文提出了一种基于Hadoop+Spark+Hive的分布式招聘推荐系统架构,解决了传统系统面临的数据规模受限、推荐精度低和实时性不足等问题。系统采用分层设计,通过HDFS存储海量数据,Spark优化... 国内服务器 7个月前840
Java 大视界 — Java 大数据机器学习模型在电商用户画像构建与精准营销中的应用 摘要:本文探讨Java大数据机器学习在电商用户画像构建与精准营销中的应用。随着电商获客成本上升,传统营销方式效率低下,Java结合大数据与机器学习技术成为解决方案。文章详细解析用户画像的四维数据体系... 国内服务器 7个月前840
计算机毕业设计Python+PySpark+DeepSeek大模型动漫推荐系统 动漫可视化 动漫爬虫 动漫大数据(代码+LW文档+PPT+讲解视频) 摘要:本文介绍了一个基于Python+PySpark+DeepSeek大模型的动漫推荐系统开发项目。系统整合多模态数据(文本、图像、音频)和用户行为数据,采用混合推荐算法(深度学习+协同过滤)实现个性... 国内服务器 7个月前840
【EI稳定】检索第六届大数据经济与信息化管理国际学术会议(BDEIM 2025) 第六届大数据经济与信息化管理国际学术会议(BDEIM2025)将于2025年12月19-21日在中国成都召开,由西南财经大学主办,西南财经大学计算机与人工智能学院、广州理工学院承办,上海海事大学支持... 国内服务器 7个月前840
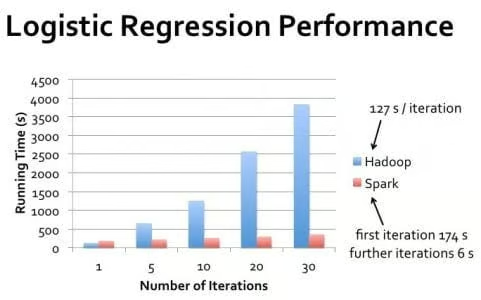
Hadoop 与 Spark:大数据框架的对比与融合 Hadoop 和 Spark 是大数据处理领域的两大主流框架,各自具有独特的优势和适用场景。Hadoop 以分布式文件系统(HDFS)和 MapReduce 计算模型为核心,适合处理大规模批处理任务... 国内服务器 8个月前840
Hadoop入门基础教程(110 问题+ 答案) 本文提供了一份全面的Hadoop入门教程,包含110道核心问题及答案,分为8个专题:基础概念与架构、HDFS原理与操作、MapReduce编程模型、YARN资源管理、集群部署运维、生态系统工具、性能优... 国内服务器 8个月前840