【Kafka】集成案例:与Spark大数据组件的协同应用 随着大数据技术的不断发展,实时数据处理和分析成为企业数字化转型的关键需求。Apache Kafka 作为一种高吞吐量的分布式消息队列系统,能够高效地处理大量数据流。而 Apache Spark 作为一... 国内服务器 9个月前1000
大数据 ETL 与人工智能的数据交互模式 数据流动:ETL将处理好的结构化数据(如Parquet文件)输出到数据仓库,AI模型(如Scikit-learn、TensorFlow)从数据仓库读取数据进行训练/推理。核心逻辑:ETL是“数据生产者... 国内服务器 9个月前1000
数据仓库与BI测试:构建决策信任基石的系统性实践 数据验证框架助力测试工程师应对数据质量挑战。随着数据量激增,传统测试方法在数据仓库和BI系统验证中面临维度爆炸、ETL管道复杂等挑战。文章提出四维验证体系:1)数据质量地基测试;2)ETL管道可视化监... 国内服务器 9个月前1000
Kafka – 网络抖动应对:重试机制、超时时间调整 本文探讨了Kafka在网络抖动环境下的优化策略,重点分析了生产者的重试机制和超时参数配置。文章首先阐述了网络抖动对Kafka可能造成的影响,包括生产者发送失败、消费者心跳异常等问题。随后详细介绍了Ka... 国内服务器 9个月前1000
Spark Shuffle:分布式计算的数据重分布艺术 本文深入探讨了Apache Spark中Shuffle机制的工作原理、演进历程和性能优化策略。Shuffle作为分布式计算中的数据重分布过程,是影响Spark作业性能的关键因素。文章首先阐述了Shuf... 国内服务器 9个月前1000
HBase数据一致性保障机制解析 一致性是分布式系统的"基石",而HBase的一致性机制是其"护城河"。掌握这些原理,能让你在设计分布式系统时,做出更明智的选择(比如什么时候用HBase,什么时... 国内服务器 9个月前1000
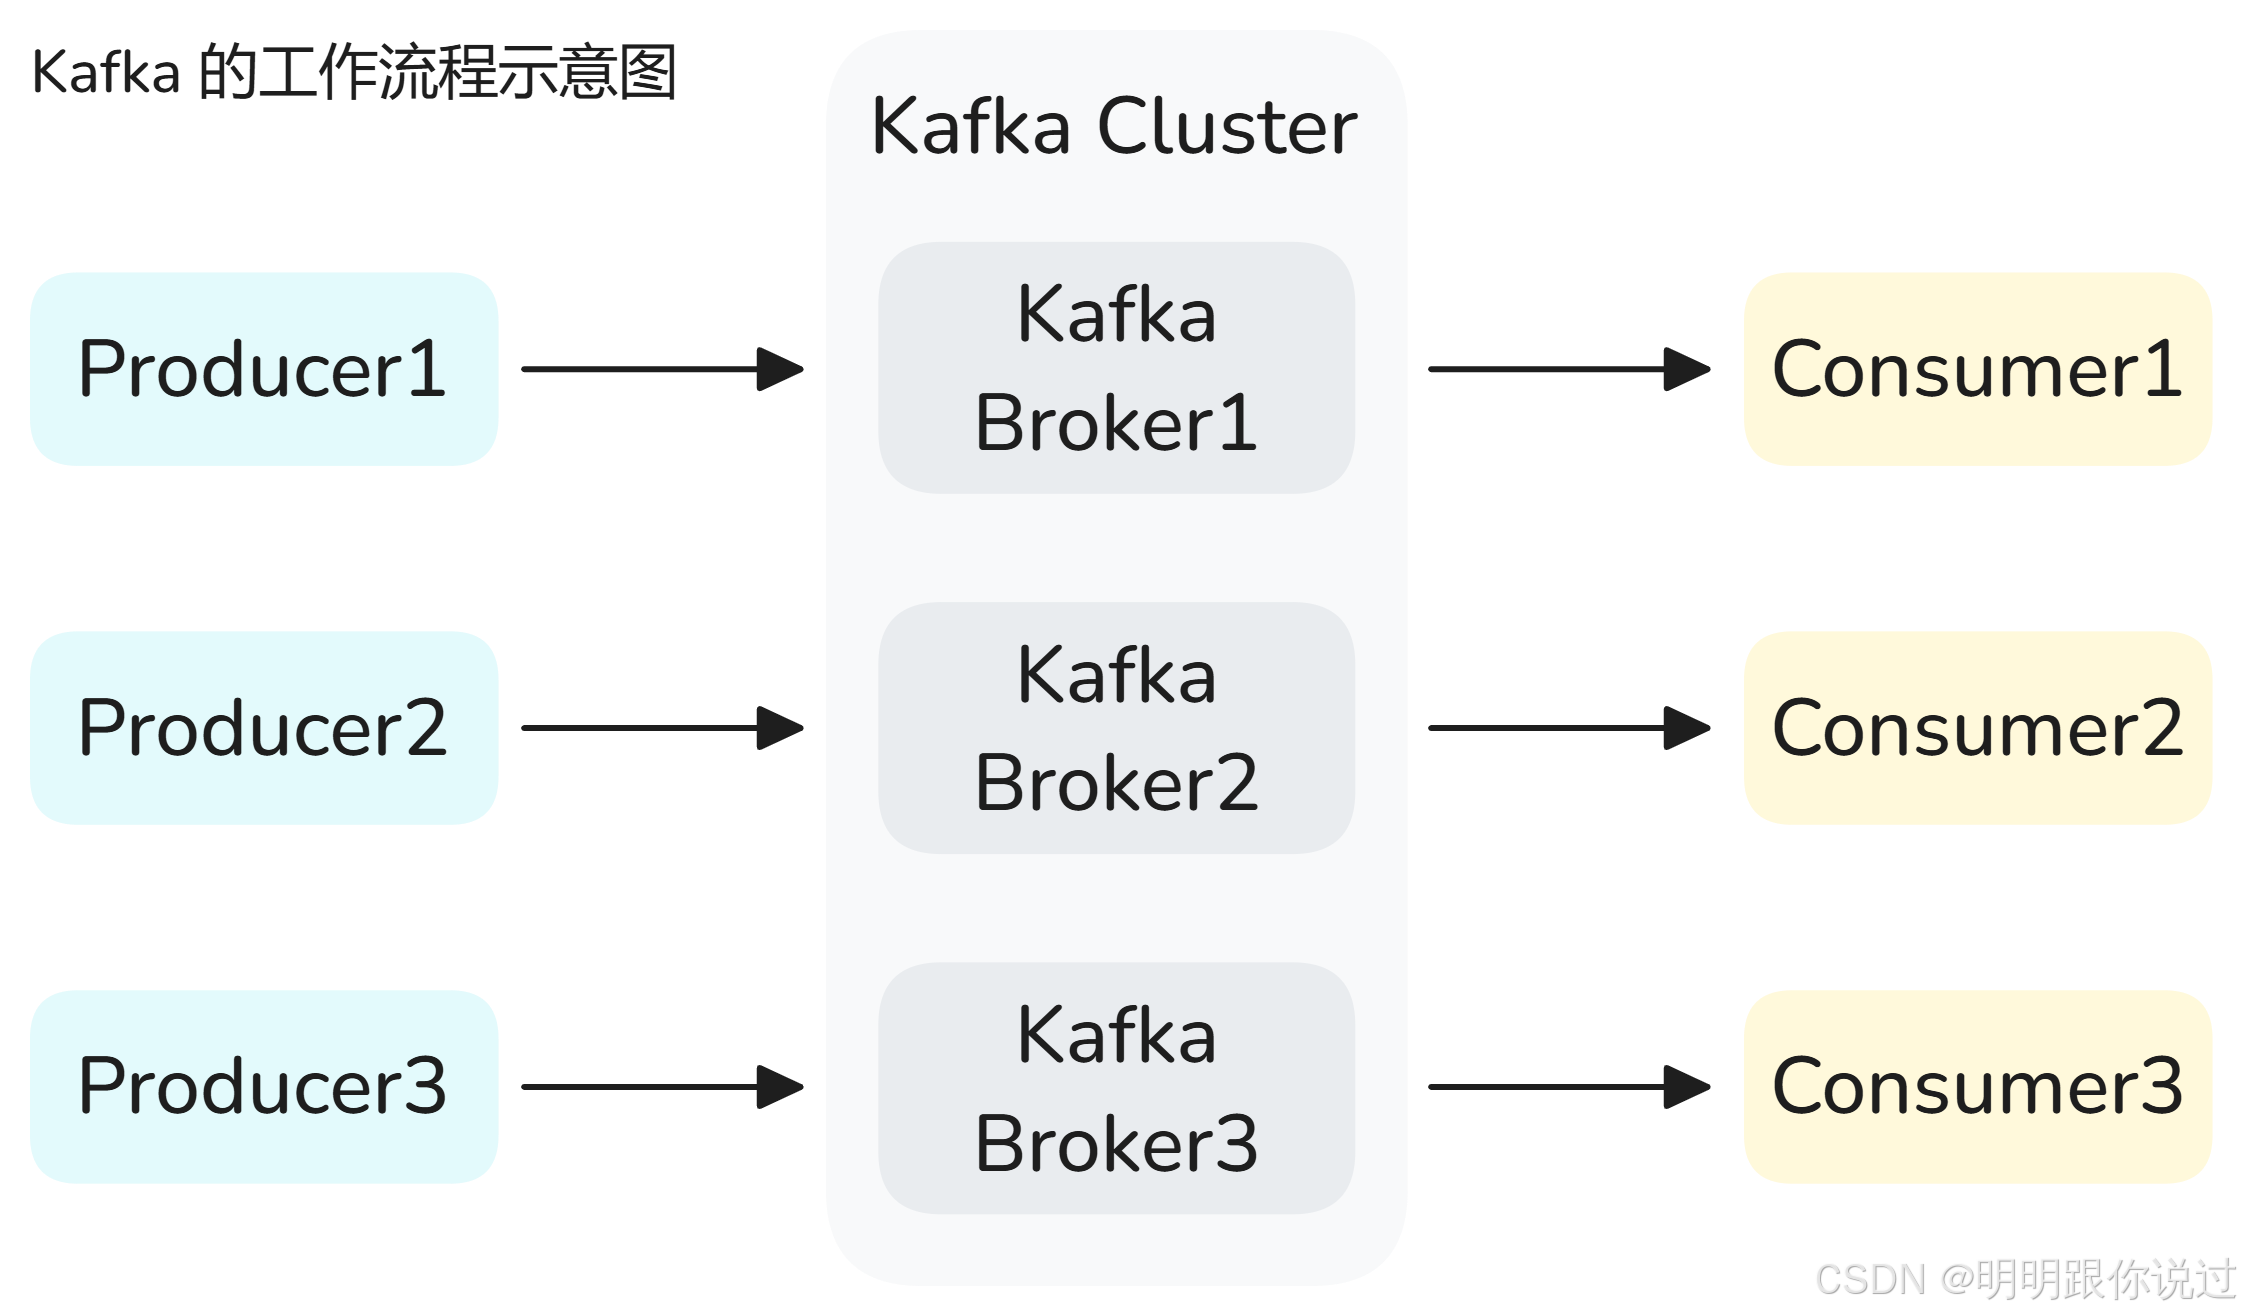
Kafka架构:构建高吞吐量分布式消息系统的艺术 本文深入探讨了Apache Kafka的分布式消息系统架构,重点分析了ZooKeeper在集群协调中的关键作用。文章从Kafka的核心组件入手,详细阐述了Broker、Producer、Consume... 国内服务器 9个月前1000
SpringBoot项目整合Zookeeper常见错误总结 本文总结了Zookeeper和Dubbo集成中的常见问题及解决方案,包括: 依赖配置问题:如缺少Zookeeper、Curator或Dubbo依赖,提供正确依赖版本; 连接配置错误:包括Zookeep... 国内服务器 9个月前1000
Spark RDD 宽窄依赖:从 DAG 到 Shuffle 的性能之道 Spark性能优化的核心在于理解并优化Shuffle过程。关键策略包括:优先使用reduceByKey等带预聚合的操作替代groupByKey,避免网络风暴;根据数据量和核心数合理设置分区数,避免并行... 国内服务器 9个月前1000
django 大数据爬虫可视化基于深度学习的个性化携程美食数据推荐系统 需要成品或者定制,文章最下方名片联系我即可~ 所有项目都经过测试完善,本系统包修改时间和标题,包安装部署运行调试,不满意的可以定制。数据库工具:Navicat for mysql。开发软件:PyCha... 国内服务器 8个月前990