RabbitMQ高级超详细笔记(2w字) 生产者重连机制与生产者确认机制,是互补而非替代的关系:生产者重连,是前置的、针对连接临时异常的被动重试保障,解决网络抖动等场景的连接问题;生产者确认,是核心的、针对投递全链路的主动结果感知,解决消息是... 国内服务器 4个月前680
GDPR助力大数据产业的健康可持续发展 本文聚焦“GDPR如何助力大数据产业健康发展”这一核心命题,覆盖GDPR的核心条款解读、对产业的具体影响机制、企业合规实践案例,以及未来趋势展望。我们不讨论法律条文的细节,而是关注“法律规则如何转化为... 国内服务器 5个月前680
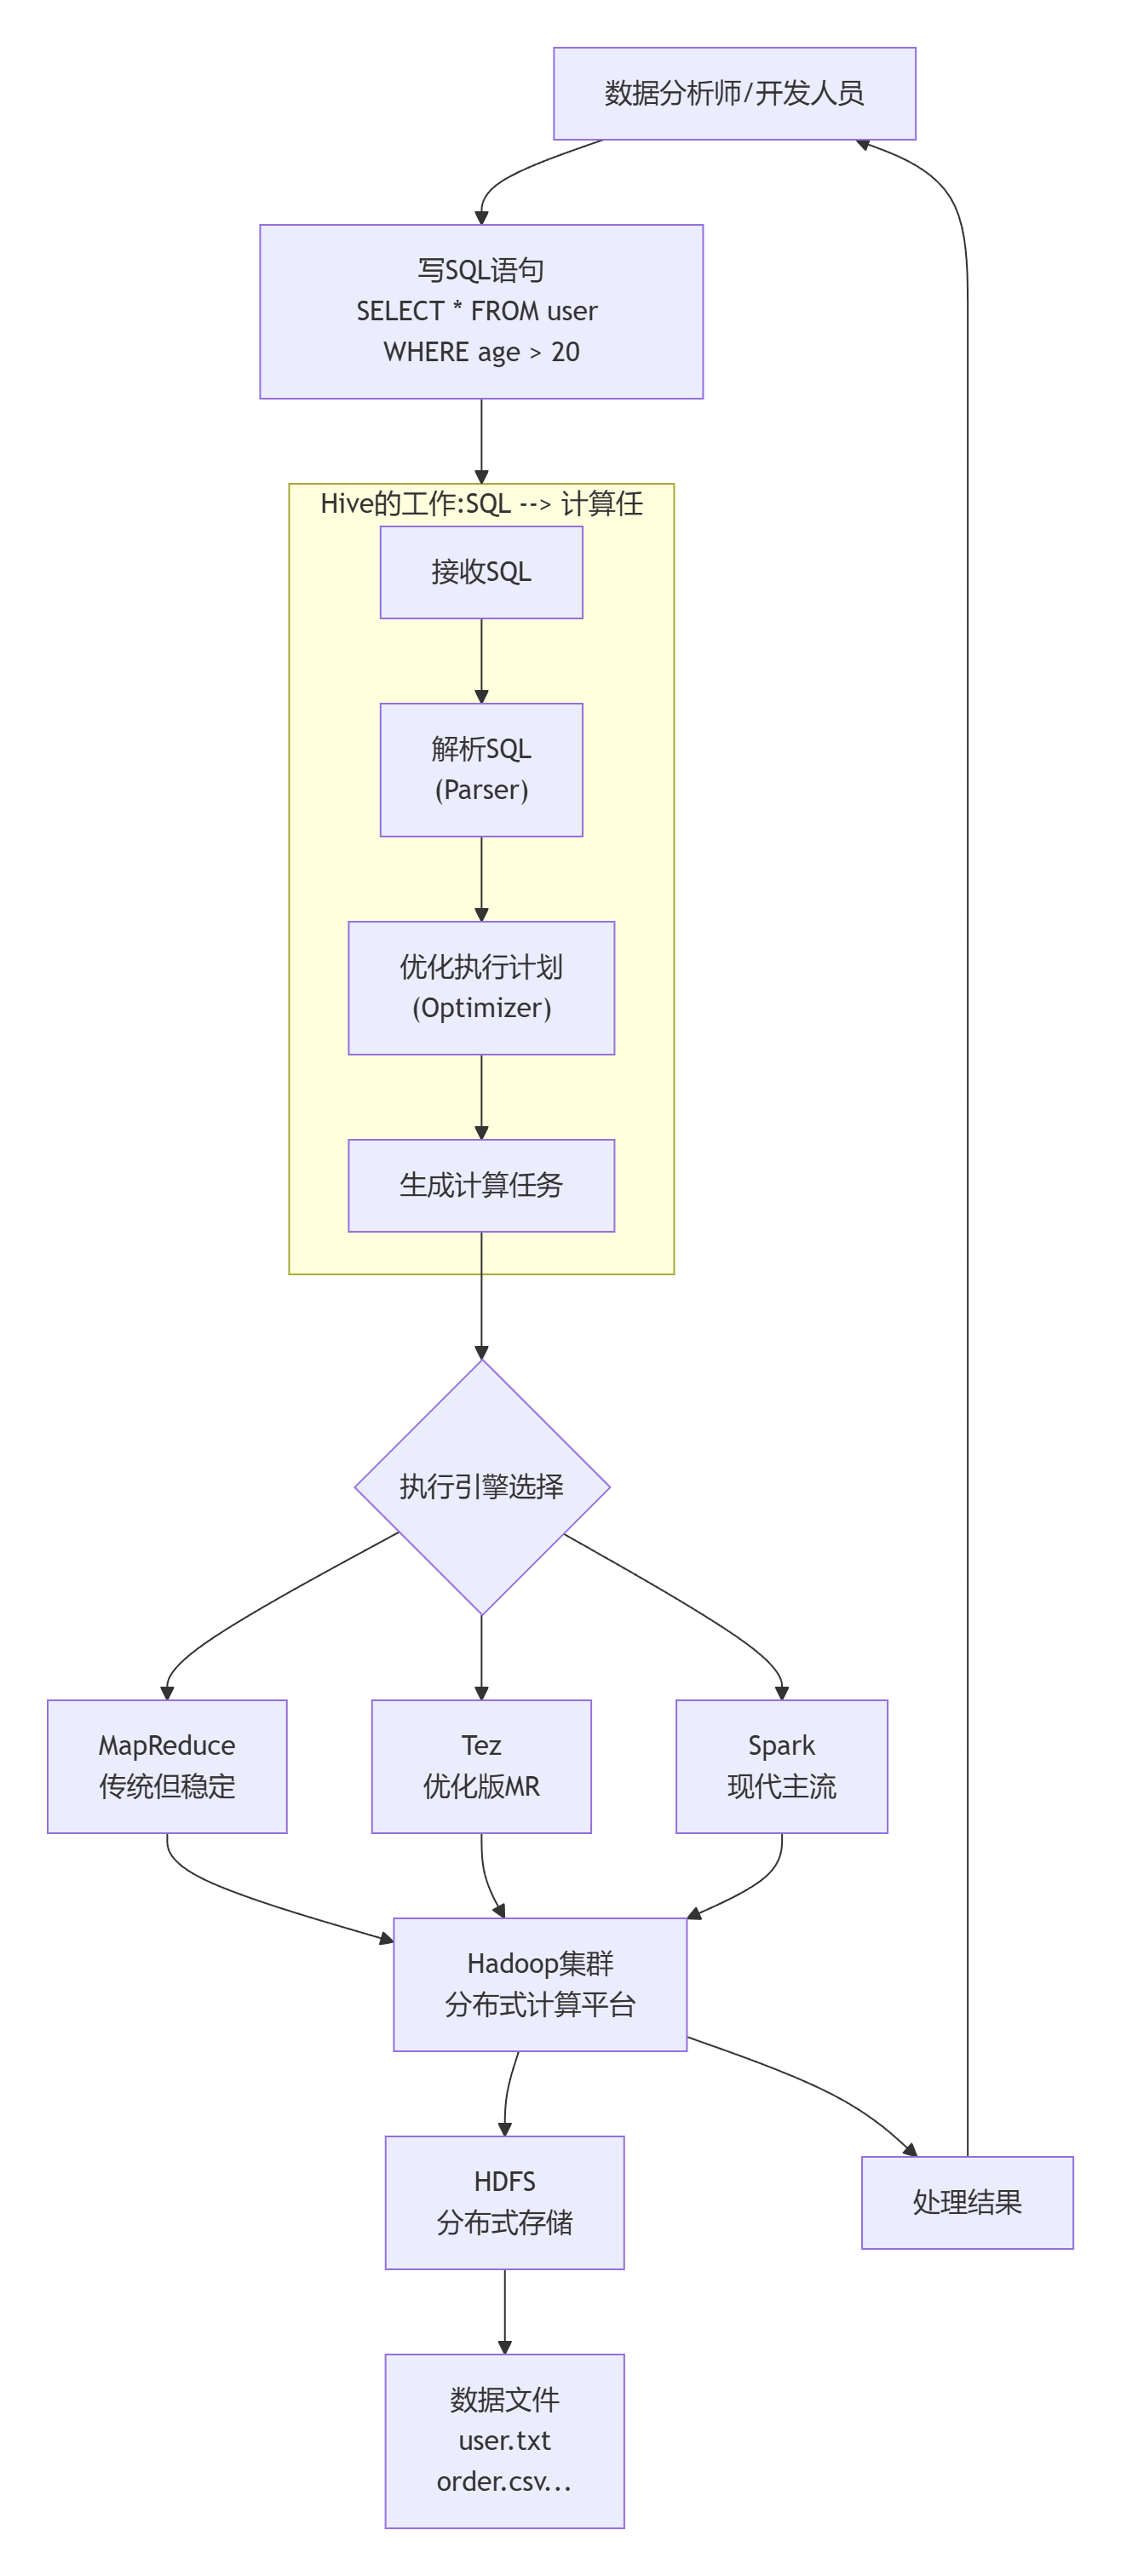
Hadoop和Hive的关系:一分钟彻底搞懂 │ 数据分析师/大数据开发 ││ 写SQL查询 │↓│ Hive ││ 把SQL翻译成分布式计算任务 ││ │ Metastore: 知道数据在哪、什么结构 │ ││ │ HiveQL: SQL方言 ... 国内服务器 5个月前680
〘 9-2 〙软考高项 | 第16章:项目采购管理(下) 本文系统梳理了采购管理中的合同管理知识体系。主要内容包括:1)按项目范围划分的合同类型(总承包/单项承包/分包合同);2)按付款方式划分的合同类型(总价/成本补偿/工料合同),重点解析了固定总价、激励... 国内服务器 6个月前680
数据仓库与数据湖:大数据运营的存储架构对比 在大数据时代,企业面临的最大挑战之一是如何高效存储、管理和利用多源异构的数据市场部门需要分析结构化的销售报表(SQL友好);算法团队需要处理非结构化的用户行为日志、图片/视频(灵活存储);管理层需要快... 国内服务器 6个月前680
KafkaUtils.createDStream vs createDirectStream:Spark Streaming整合Kafka的两种方式 维度核心原理Receiver接收+缓存+WALDriver调度+Task直连数据流偏移量管理ZookeeperSpark/外部系统语义保证并行度由Receiver数量决定与Kafka分区数一致适用版本... 国内服务器 6个月前680
Couchbase 向量存储与 Spring AI 集成技术详解 Couchbase 向量存储与 Spring AI 的结合,为 AI 应用提供高效、可扩展的底层能力。其自动化配置、多样的检索机制和完善的元数据过滤功能,让开发者能快速落地智能搜索、推荐等功能。随着大... 国内服务器 6个月前680
大数据领域存算分离:数据湖建设的关键支撑 本文旨在全面解析存算分离架构在大数据领域,特别是数据湖建设中的应用价值和技术实现。存算分离的基本概念和演进历程数据湖架构的核心组件和设计原则存算分离如何解决传统大数据架构的痛点主流技术实现方案和最佳实... 国内服务器 7个月前680
Zookeeper 3.2.0 之后最被低估的特性:Chroot 命名空间隔离 你以为 Zookeeper 只是存数据?其实 3.2.0 之后的 Chroot,才是真正的“多租户隔离神器”。一次合租式生产事故,让我彻底理解命名空间的重要性。今天用一个故事,带你彻底搞懂它。 国内服务器 7个月前680
计算机毕业设计PySpark+Hive+大模型小红书评论情感分析 小红书笔记可视化 小红书舆情分析预测系统 大数据毕业设计(源码+LW+PPT+讲解) 摘要:本文提出基于PySpark、Hive与大模型的混合架构情感分析方案,针对小红书平台海量用户评论数据进行高效处理。系统采用分层架构设计,通过PySpark实现分布式计算,Hive构建高效数据仓库... 国内服务器 7个月前680