Kafka核心优化机制:Batch+Request底层原理与缓冲池设计深度解析 Kafka通过Batch+Request机制实现高吞吐传输,核心原理是分层批量处理:消息先按分区封装为Batch,再按Broker聚合为Request,减少网络IO次数。客户端采用CopyOnWrit... 国内服务器 9个月前1090
通过实践聊聊NVIDIA DGX Spark真的适合部署企业级大模型吗? NVIDIA推出基于Grace Blackwell超级芯片的GB10主机,搭载20核ARM CPU(10大核+10小核)和6144 CUDA核的Blackwell GPU,FP4算力达11PetaFL... 国内服务器 9个月前1090
数据仓库生命周期全解析:从数据采集到智能应用的完整旅程 在当今这个数据驱动的时代,企业每天产生的数据量呈指数级增长。根据最新的行业统计,到2025年,全球数据总量预计将达到215ZB,其中企业数据占比超过70%。面对如此庞大的数据量,传统的数据库系统已经难... 国内服务器 9个月前1090
rabbitmq面试题 本文详细介绍了RabbitMQ的核心概念与应用场景,重点分析了RabbitMQ的消息可靠性机制。主要内容包括: RabbitMQ基础概念 定义:基于AMQP协议的开源消息中间件 核心应用场景:服务解耦... 国内服务器 9个月前1090
大模型应用技术之 Spring AI 2.0 变更说明 Spring AI 2.0.0-M1 发布重要里程碑版本,基于Spring Boot 4.0和Spring Framework 7.0构建,需Java 21运行环境。主要更新包括:新增Redis聊天记... 国内服务器 9个月前1090
大数据视角下的时序数据库选型:Apache IoTDB 核心竞争力拆解 随着5G、物联网与工业互联网的深度融合,时序数据正以爆炸式速度增长——工业传感器的高频采集、智能电网的实时监测、车联网的动态反馈,每天都在产生PB级时序数据。据统计,2025年国内企业时序数据产生量同... 国内服务器 9个月前1090
大数据领域Hive在医疗科技行业的数据处理应用 医疗科技行业正经历着前所未有的数据爆炸式增长。从电子健康记录(EHR)、医学影像到基因组数据,医疗数据的规模、复杂性和多样性对传统数据处理技术提出了严峻挑战。本文旨在探讨Apache Hive如何作为... 国内服务器 9个月前1090
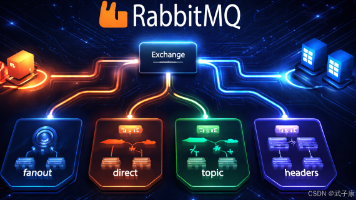
Java-200 RabbitMQ 架构与 Exchange 路由:fanout/direct/topic/headers Exchange → Binding → Queue → Consumer 的链路讲清消息如何被投递与为什么会“投递不到”。重点拆解四类交换器:fanout(广播)、direct(精确路由键匹配)、t... 国内服务器 9个月前1090