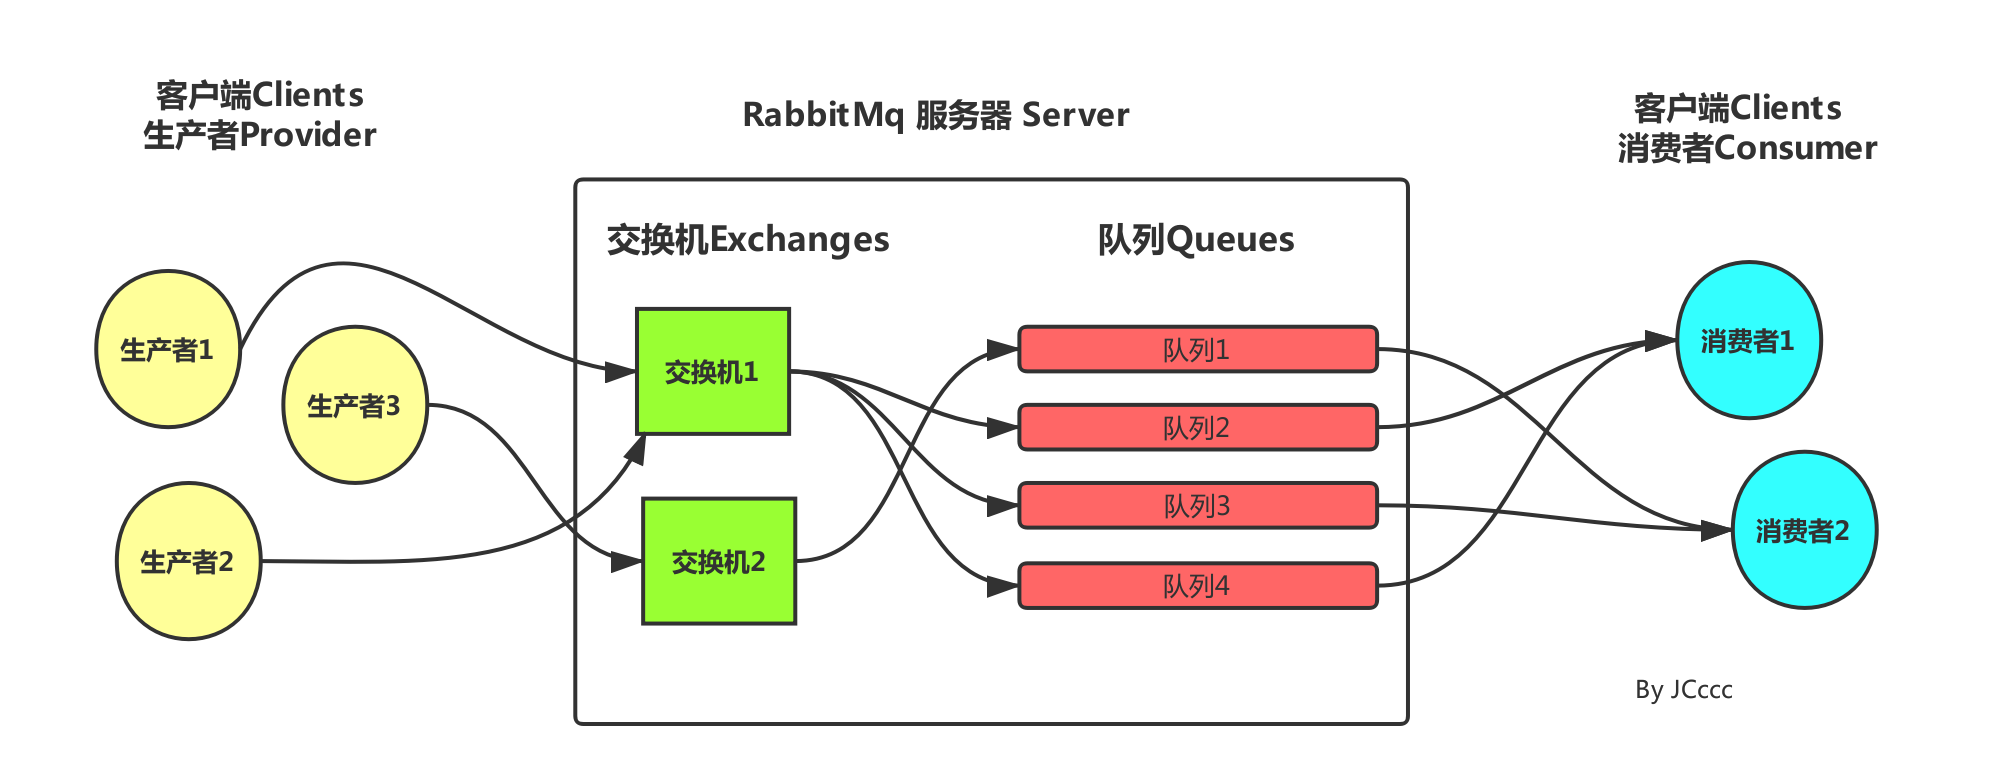
RabbitMQ之交换机 在讲交换机之前我们需要了解一些概念,在RabbitMQ工作流程有一项叫Exchange(交换机:消息的分发中心****),它的作用是将生产者发送的消息转发到具体的队列,队列再将消息以推送或者拉取方式给... 国内服务器 7个月前660
Pyspark学习二:快速入门基本数据结构 实际工作中其实不需要自己安装和配置,更重要的是会用。所以就不研究怎么安装配置了。前面介绍过:简单来说,Spark是一款分布式的计算框架,用于调度成百上千的服务器集群,计算TB、PB乃至EB级别的海量数... 国内服务器 7个月前660
大数据背景下时序数据库选型指南:国产开源技术的突破与实践 摘要: 在大数据时代,时序数据管理面临写入频繁、存储量大等挑战。Apache IoTDB作为专业时序数据库,通过树状数据模型、高效压缩算法和分布式架构,实现千万级数据点/秒写入和毫秒级查询。其支持SQ... 国内服务器 8个月前660
Spring Boot 全局异常处理策略设计(二):DispatcherServlet 与异常解析责任链源码解析 摘要:本文深入解析Spring Boot全局异常处理机制,重点剖析DispatcherServlet的核心作用及其异常处理流程。文章揭示了异常处理的责任链模式,详细介绍了HandlerExceptio... 国内服务器 8个月前660
查到进程的PID 摘要:本文介绍了如何通过ADB命令查找Android设备中update_engine进程的PID及其组权限。首先使用"ps -A | grep update_engine&q... 国内服务器 8个月前660
15、RabbitMQ 4、消息丢失怎么办(怎么防止消息丢失|怎么保证消息的可靠性?|使用MQ的时候有没有可能出现什么问题)9、在项目中你们使用的是MQ的哪种模式?(死信队列、死信交换机)3、详细说一下MQ是怎么用的?1、微... 国内服务器 8个月前660
【深度解析】Kafka生产者核心原理:从异步发送到数据可靠性保证 摘要: 本文深入解析Kafka生产者的核心原理,涵盖异步发送、回调机制、分区策略及数据可靠性保证。通过架构图展示生产者内部的双线程设计(主线程与Sender线程),解释高吞吐量的实现关键——批处理与缓... 国内服务器 8个月前660
Flink原理与实战(java版)#第11章Flink的应用(第三节Table & SQL 连接器之Hive(三)) 介绍Hive作为Table API和SQL的外部连接器使用,并且结合实际应用中会使用kafka作为数据源进行介绍。 国内服务器 8个月前660
消息队列 Kafka/RabbitMQ/RocketMQ 怎么选?业务场景对比指南 你的场景推荐方案核心理由我要做大数据平台、日志中心Kafka吞吐为王,生态无敌我要做电商订单、支付、金融RocketMQ事务消息,堆积不卡,国产之光我要做后台任务调度、微服务解耦RabbitMQ路由灵... 国内服务器 4个月前650
构建现代化实时数据仓库的完整解决方案:从技术选型到企业级实战 实时数仓作为企业数字化转型的核心基础设施,正成为大数据领域的技术焦点。本文将深入解析基于Flink、Doris、Paimon等主流技术栈的企业级完整解决方案,涵盖架构设计、实战部署到性能优化的全流程... 国内服务器 5个月前650